ブラウザのタブ1つで動画を並列にデコードする
Video2Any には、ほかのすべてを決めてしまう制約がひとつあります。動画が利用者の端末から出ないことです。アップロードしないので、処理を代わりに行うサーバーもありません。デコードも比較も描画も、すべてブラウザのタブの中で行われます。そのタブは同時に画面も動かし続けなければなりません。
この制約に実際どれだけの手間がかかるのか、そしてサイトのほかの部分が何でできているのかを書きます。
このページの内容
デマルチプレクサは自分で書くしかない
WebCodecs が提供するのは VideoDecoder です。エンコードされたチャンクをフレームに変える部品で、チャンクそのものは提供されません。ブラウザ自身は MP4 パーサーを持っていて `<video>` はそれで動いていますが、そのパーサーを渡す API はありません。そこでコンテナは自分で読みます。ボックスをたどり、moov を見つけ、サンプルテーブルを読み、EncodedVideoChunk を1つずつデコーダーに渡します。
コンテナを自分で読むと、副次的な利点がひとつ付いてきます。利用者が5分待たされる前に、このファイルが開けない理由を伝えられます。ProRes は編集用のフォーマットで、どのブラウザもデコードしません。それが分かるのは moov を読んだときであり、ProRes の moov はファイルの先頭ではなく末尾にあることが多いのです。私たちのプローブが先頭と末尾の両方を走査しているのは、そのためです。
スイープとキャプチャに分ける理由はメモリ
素直にやるなら、全フレームをデコードして順に比較します。ただし92分・25fpsの録画は138,000フレームあり、1080p でその量をタブが抱えることはできません。
そこでエンジンは処理を2つのパスに分けます。1つめのスイープは、サンプル点だけをデコードし、各サンプルを160×90で保持します。この大きさなら動画全体でもピクセルは数十MBに収まり、それでいてスライドが切り替わったことは判別できます。検出器が選び終えてから、2つめのキャプチャが全解像度のフレームを取りに戻ります。取りに行くのは選ばれたサンプルだけです。スイープが取れるサンプルは最大900枚で、この上限から知っておく価値のある結論が出ます。29分の動画と92分の動画で、かかる時間はほぼ同じです。コストは分単位ではなくサンプル単位で発生するからです。
チャンクごとにワーカー1つ、デコーダーも1つずつ
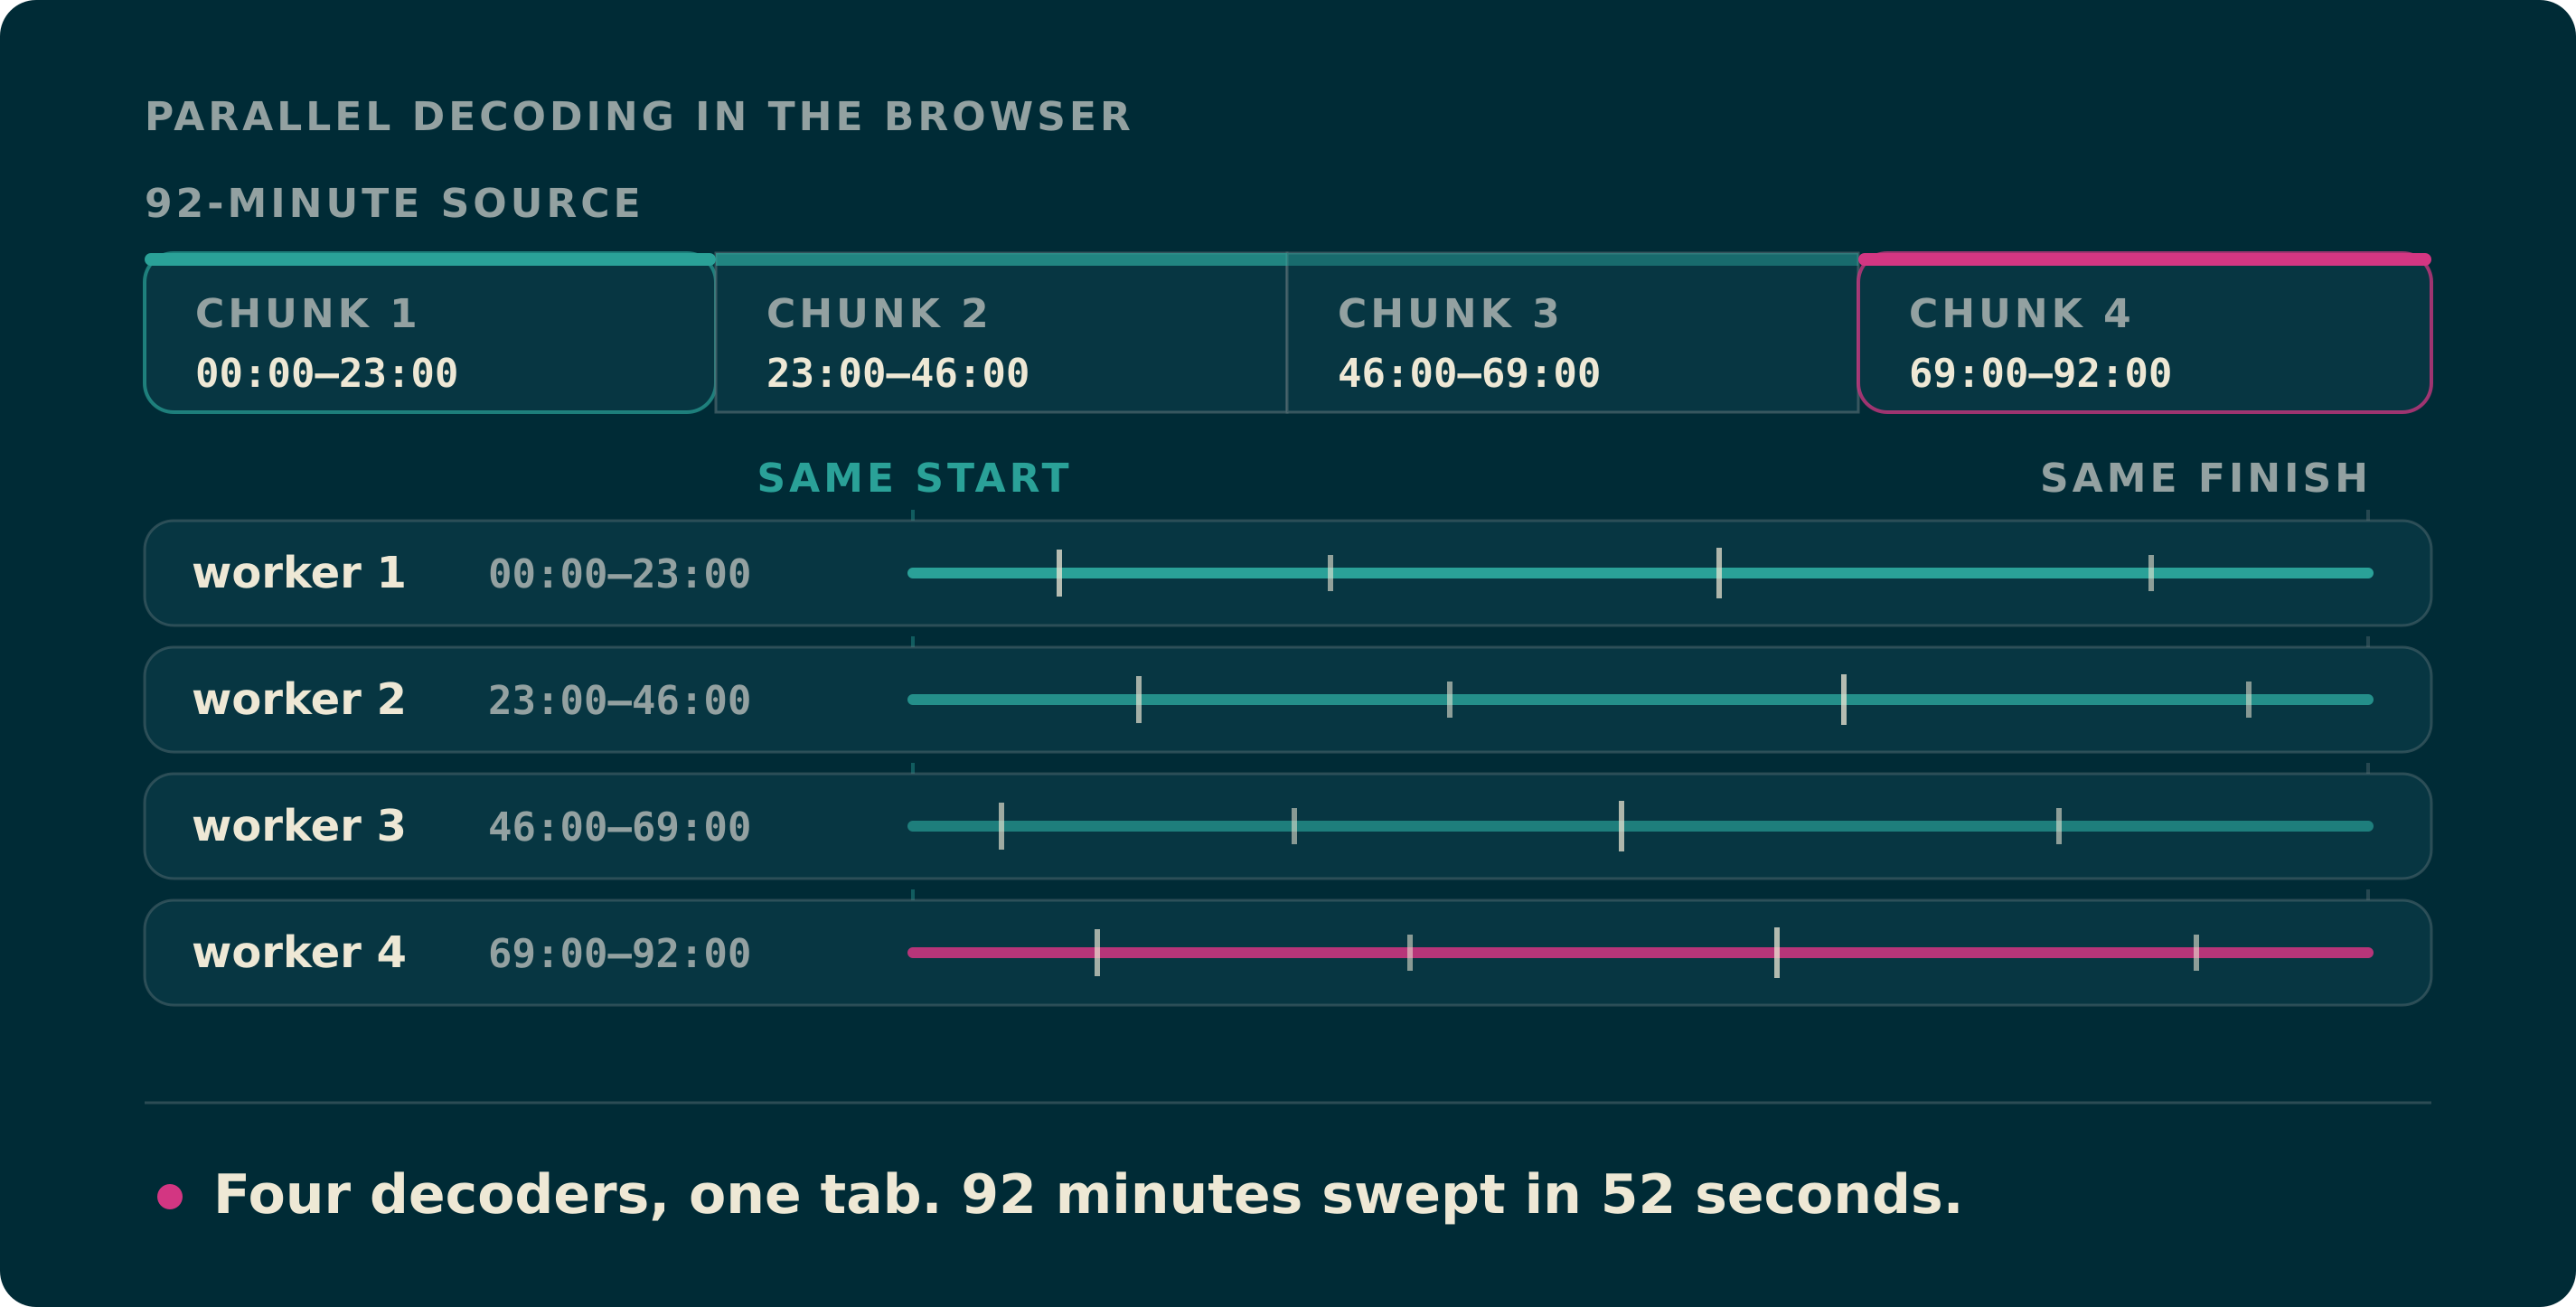
エンジンは動画を時間で分割し、各チャンクを自前の VideoDecoder を持つワーカーに渡します。プールの大きさは min(4, コア数 / 2) です。半分しか使わないのは、タブが画面も動かしているからで、4 で頭打ちにしている理由は次の節で説明します。
各チャンクは自分の範囲の少し手前から走査します。最初のフレームを判断するための比較対象が要るからで、そのあと自分の範囲外は捨てます。スライドは最後にまとめてではなく、キャプチャが1枚終わるたびに流れ出します。
分割の代償
代償は2つあります。1つめは較正です。各チャンクは自分の区間だけでしきい値を較正するため、同じ動画でも4分割したときと8分割したときで出来上がるスライドが変わります。つまり**結果がマシンのコア数に左右される**わけです。2つめは重複です。各チャンクは自分の中でしか重複を落とさないので、会議で何度も戻ってくる同じ画は、登場したチャンクの数だけ残ります。29分の録画では9枚中3枚が重複でした。
重複は直しました。判定をメインスレッドに移し、スライドが届くたびに比較します。較正のほうは直していません。全体で較正する版を書いてはみたのですが、結果は悪くなりました。同じ会議で ffmpeg が本物のカットを7つ数えるのに対し、チャンクごとの較正は6枚を見つけ、全体較正は4枚しか見つけられませんでした。だからプールは4のままです。チャンクを増やせば約25%速くなりますが、そのぶん答えが変わってしまうからです。
読み終わるまで、1枚も出せない
しきい値は動画全体のフレーム間差分の分布から決まります。だから検出器は、最後のフレームをサンプリングし終えるまで最初の1枚すら選べません。92分の録画ならスイープに52秒、最初のスライドが出るのは50秒目です。
これは性能の問題ではなく、並列度をいくら上げても消えません。フィードバックの問題です。そして解決策は、ただのパーセンテージだった場所に「動画を読み込み中 · 45:46 / 92:08」と書くことでした。
周辺のスタック
API は Cloudflare Workers と Hono で動かし、アカウントとメタデータは D1、本当に保存が要るわずかなものは R2 に置いています。フロントは React 19 と TanStack Router、Tailwind v4、better-auth です。8言語あり、それぞれに URL プレフィックスとルーターの basepath があります。
サイトはサーバーレンダリングではなく**プリレンダリングされた SPA** です。公開ページはすべてデプロイ時に作られた静的 HTML のスナップショットで、だからマーケティングページはキャッシュが効いて速く、コンバーター自体はサーバーをまったく必要としません。例外はひとつだけです。`/app` 配下は静的なシェルなので、エディタはアカウントについて何も知らない状態で起動し、サーバーに問い合わせるしかありませんでした。そして答えが返る前に作業を始めてしまい、ある有料会員が無料プランの30分制限を受ける事故が起きました。ワーカーはそのページを返す時点でセッションを持っているので、いまはプランをドキュメントに書き込み、最初のレンダーで分かるようにしています。これらの応答は private でキャッシュしません。ほかのページの公開キャッシュはそのままです。
なぜそこまでするのか
サーバーを立てれば、ここに書いたことの大半は消えます。ただしそれは、誰かが変換する講義も、社内会議も、診療の録画も、すべてこちらのマシンを通るということです。この製品が存在する理由は、それが起きないことにあります。
制約こそがこの製品そのものです。上に書いたのは、それを守るために払っている代償です。