アルゴリズムの不具合に見えた8つのバグ
Video2Any は、ブラウザでフレームをデコードし、直前のフレームと比較して、十分に変化したものだけを残す、という手順でスライドを見つけます。結果がおかしいとき、まず疑われるのはこの比較処理です。ですが、原因がそこにあることはめったにありません。
一週間で追いかけた8件を並べます。検出器そのものが原因だったのは2件だけでした。残りは、消し忘れたガード、数字が合わないテストスクリプト、仮想スクロールのリスト、API 呼び出しとの競合、メモリが上限に達したこと、そしてエラーログです。最後の1件では、エラーのうち唯一役に立つ部分がログから抜け落ちていました。
8件
1. 変えても何も起きないコントロール
「短い動画で Dense を選んでも3枚しか出ず、Default と同じだ」という報告が届きました。しきい値の計算式をしばらく眺めたあとで、いちばん基本的なことを確かめました。その設定は、そもそも検出器まで届いているのか。
届いていませんでした。最初のスイープは、ファイルごとに一度だけ走るよう ref で守られています。密度を変えるとコールバックは作り直されますが、このガードが effect をその場で押し返してしまい、実際に再実行できるのは無関係な通知にあるボタンだけでした。切り替えたあとに見えていたのは前回の結果で、タイムスタンプまで同じです。修正後、同じクリップで Sparse / Default / Dense はそれぞれ3枚、6枚、13枚になりました。以前は3つとも6枚でした。
2. テストスクリプトが二度とも違う数を出した
おかしな結果を説明するために、Node でパイプラインをオフラインに作り直し、同じファイルを流しました。ところが出てきた数字は本番と食い違い、しかも二度とも食い違う向きが逆でした。最初はスクリプトが1枚で本番が6枚、直したら今度はスクリプトが15枚で本番が6枚です。
原因は2つありました。スクリプトは ffmpeg でグレースケールのフレームを抜いていましたが、ブラウザがエンジンに渡すのは canvas の RGBA です。縮小フィルタの違いだけで、較正後のしきい値は 0.618 から 0.650 まで動きます。さらにスクリプトは、アクティビティマスクを使うかどうかを決める関数を飛ばしていたため、本番と同じ経路を通っていませんでした。アルゴリズムだけを再現してパイプラインを再現していないスクリプトは、間違った答えを自信たっぷりに返してきます。
3. DOM にあるのは画面に映っている分だけ
32分の動画で30分以降のスライドが出ることを確かめるテストがありました。このテストはサムネイルのタイムスタンプをすべて読み、最後の1枚を 27:00 と報告します。解析が途中で打ち切られたときとまったく同じ見え方です。
あのグリッドは仮想スクロールで、要素として存在するのは表示中の行だけです。先に最下部までスクロールしてから読み直すと、本当の最後は 32:00 でした。このアサーションが測っていたのは、データではなくビューポートだったわけです。
4. ワーカーがそれぞれ別々に重複を消していた
長い動画は、複数のチャンクに分けて並列にスイープします。各ワーカーは自分の担当区間の中だけで重複した画面を落とします。発表者が前のスライドに戻る、会議の映像が同じ画に戻る、といった場面です。ワーカーどうしは互いの結果を見られません。
そのため、繰り返し出てくる画面は、登場したチャンクの数だけ残ってしまいます。29分の会議録画では、9枚のうち3枚が重複でした。さらに厄介なのは、これだと最終的な枚数がチャンク数、つまり利用者のマシンのコア数に左右されることです。いまは重複判定をメインスレッドに移し、スライドが届いたその場で比較しています。重複した1枚が一度表示されてから消える、ということも起きません。
5. 正しいはずの設計のほうが結果は悪かった
各チャンクが自分の区間だけでしきい値を較正するのは、どう考えても筋が通りません。動画は1本、分布も1つ、しきい値も1つのはずです。そこで、そのとおりに書き換えました。ワーカーが測った比率を送り、メインスレッドがそれをまとめて一度だけ較正し、答えを返します。
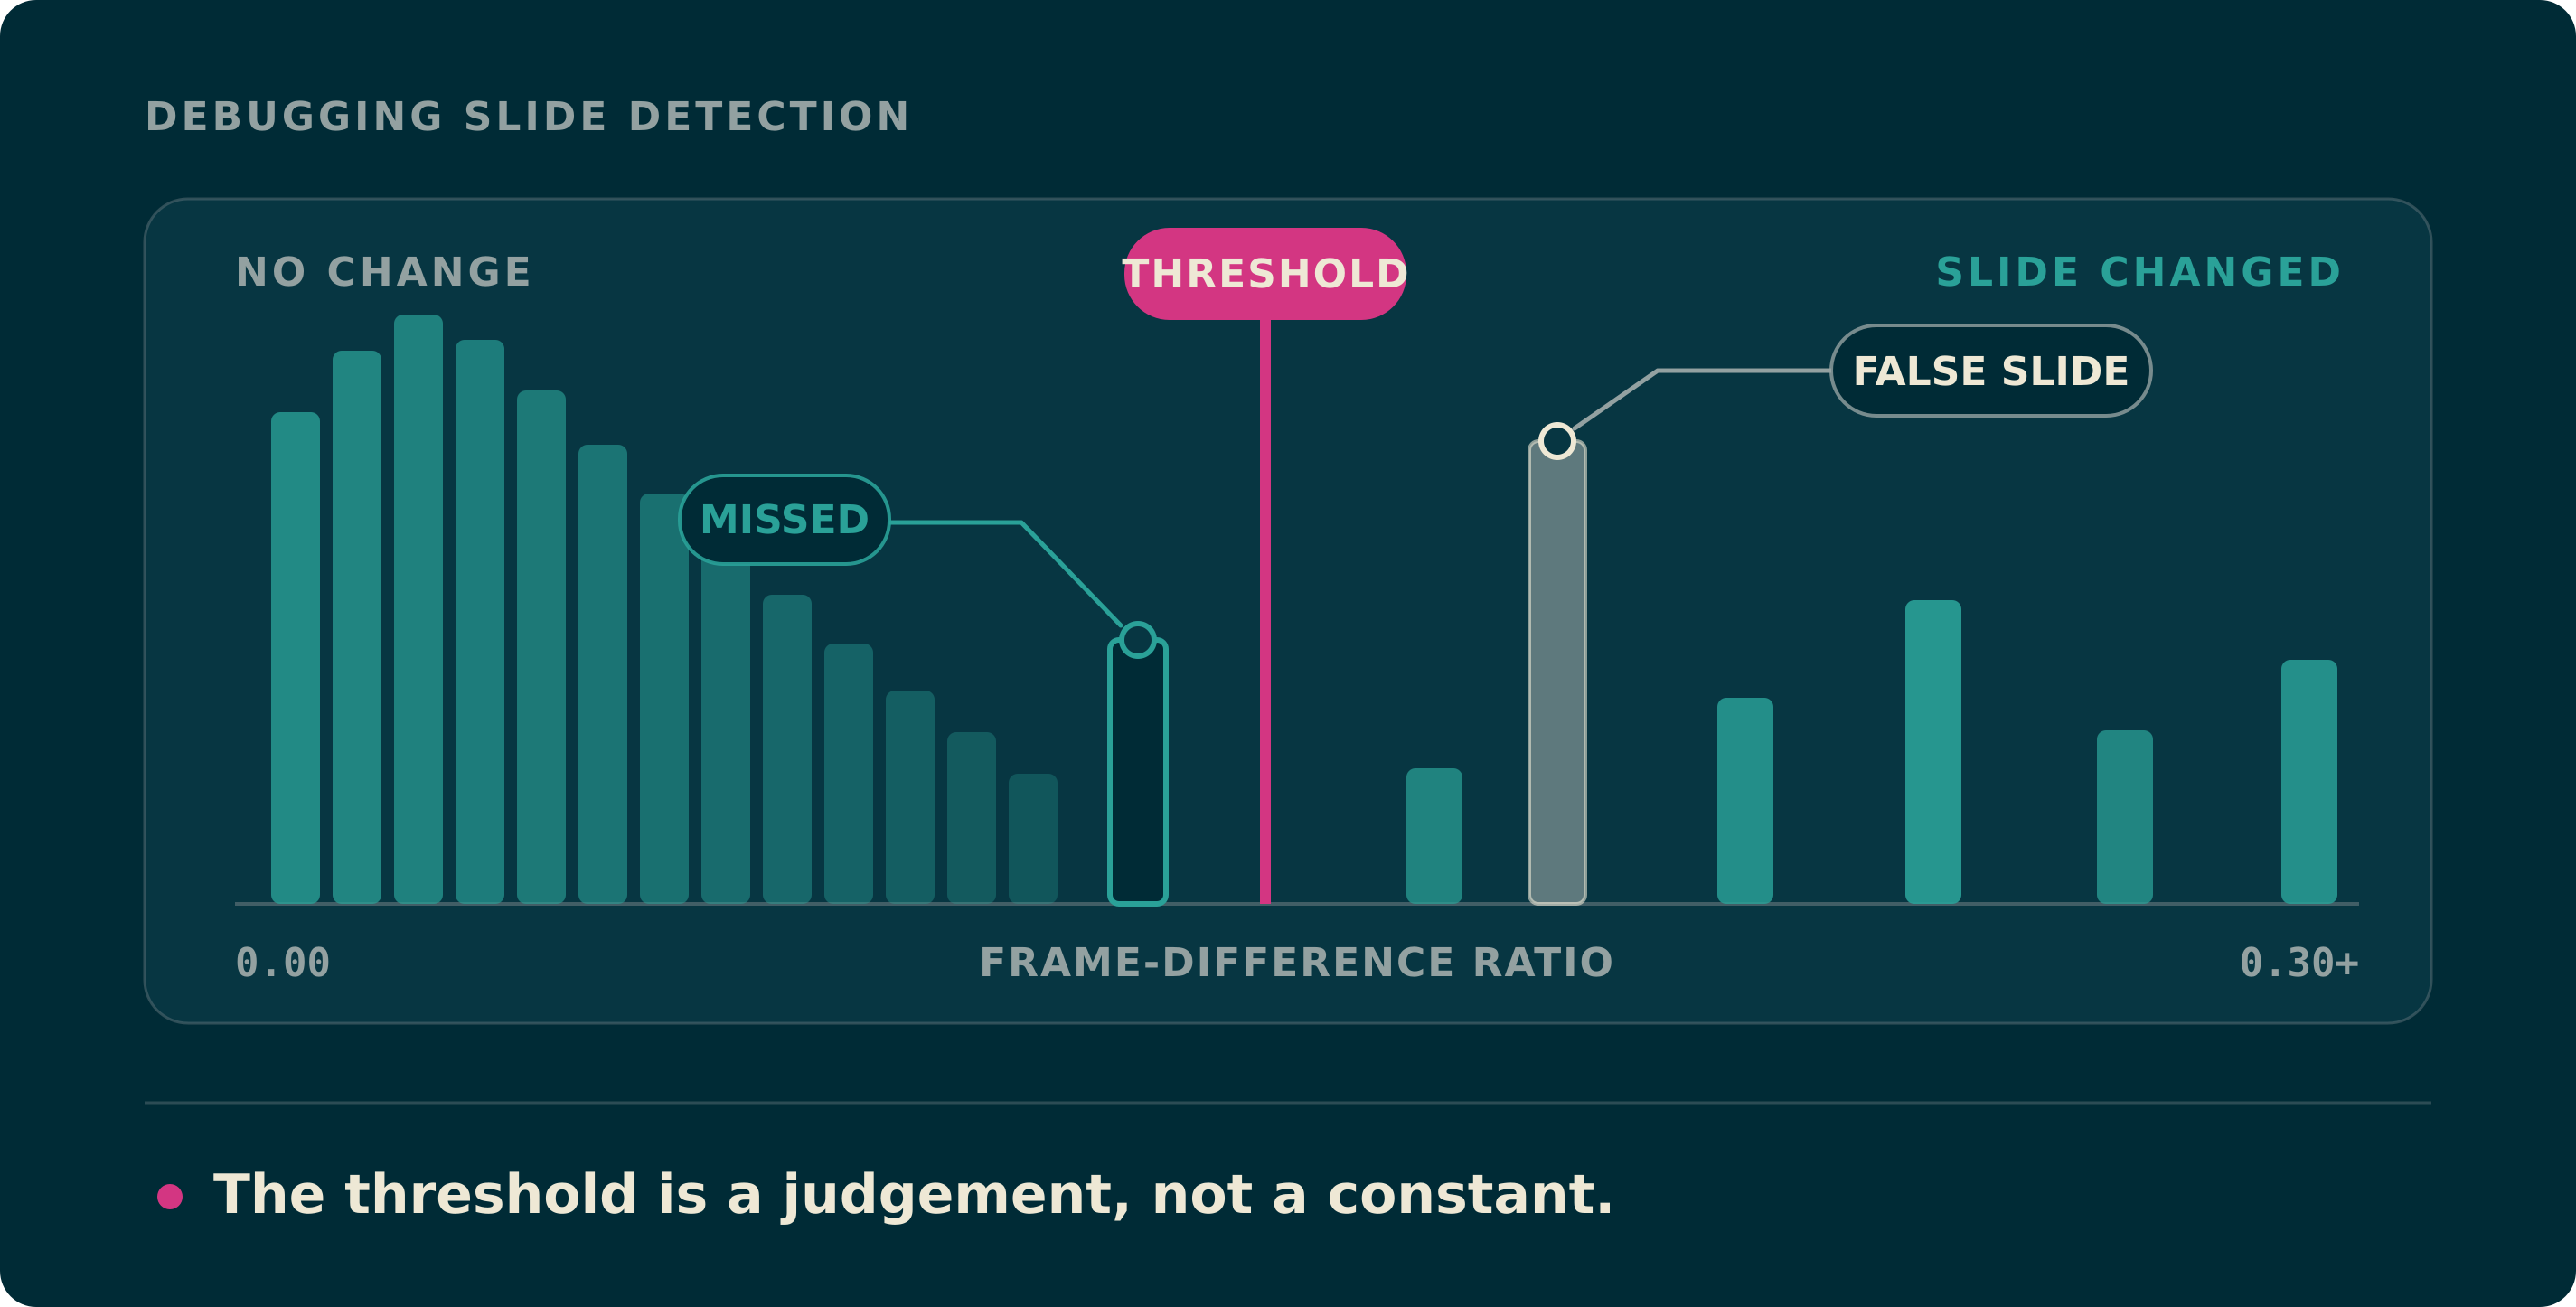
4チャンクと8チャンクの差は、3枚から1枚に縮みました。そのうえで、結果は悪くなりました。同じ29分の会議で、ffmpeg 自身のシーン検出は本物のカットを7つ数えます。チャンクごとの較正に上の重複除去を足すと6枚、全体で較正すると4枚です。比率をまとめると分布が広がり、median + 2·MAD が上がり、本物の切り替わりが落ちます。この変更は revert しました。設計として筋が通っていても、いま動いているものに負けることはあります。そしてそれを見分けられるのは、自分のコードの外に照合できるものを持っているときだけです。
6. 答えが「いいえ」なのではなく、まだ訊いていなかった
有料プランの方が長い録画をアップロードしたところ、解析されたのは最初の30分だけでした。再サンプリングを押すと全体が出ます。だからこそ、検出の問題に見えたのです。
エディタは、相手が誰かを知る前に動き始めます。権限フラグの初期値は false ですが、この false は「権限がない」という意味ではなく、「まだ返事が来ていない」という意味です。長さの上限はその false を読み、無料プランの上限を当てていました。再サンプリングのころには、プラン情報はすでに届いています。最初はそれを待つように直し、次に待つ必要そのものをなくしました。ページを返す時点でワーカーはセッションを持っているので、プランをドキュメントに書き込んでおけば、最初のレンダーで分かります。
7. すべてのエラーの名前が「Error」だった
文字起こしは成功より失敗のほうが多く、5対6でした。そしてその全部が「Error」という文字列で記録されていました。19件の抽出失敗も同じです。
コードが記録していたのは err.name です。人が手で作った Error は、どれもこの値が「Error」になります。情報が入っているのは message のほうですが、そちらはどこにも残っていませんでした。message を記録するようにして、ようやく失敗の仕組みが分かりました。decodeAudioData はオーディオコンテキストのサンプルレートに合わせてリサンプルします。そのため、ハードウェアの 48 kHz ステレオで55分の講義をデコードすると、ほかの処理に入る前に約630MBの浮動小数点サンプルが確保されます。2時間なら 1.4 GB です。最初から 16 kHz のコンテキストでデコードすれば、モデルが受け取る音声は同じままで、メモリはおよそ6分の1で済みます。
8. 速いのに、壊れているように感じる
92分の会議録画は、52秒でスイープが終わります。最初のスライドが出るのは、そのうちの50秒目です。
遅い処理はどこにもありません。しきい値はフレーム差分の分布全体から較正するので、動画を最後まで読み終えるまで1枚も選べないのです。そしてその50秒のあいだ、画面にはパーセンテージしかありませんでした。ほかに何もない画面で数字だけが動いていると、利用者は処理が止まったと受け取ります。いまは、どちらの工程が動いているか、動画のどこまで読んだかを表示します。同じ52秒が、苦情の対象ではなくなりました。
一週間前の自分に言うとしたら
コードを推理する前に、入力がそのコードまで届いているかを確かめること。今回の8件のうち半分は、設定が届いていない、答えがまだ返っていない、テストが別のものを測っている、のどれかでした。
そして、自分のパイプラインの外に照合できるものを1つ持っておくこと。ffmpeg のシーン検出は我々が作っているものではありませんし、そうである必要もありません。我々の実装と無関係でさえあれば十分です。あれがなければ、較正の書き直しをそのまま公開していたはずです。設計としては良かったからです。そして本物のスライド7枚のうち3枚を、気づかないまま落としていたでしょう。