一个浏览器标签页如何并行解码视频
Video2Any 只有一条约束,其余的设计都是从它推出来的:视频不离开你的机器。文件不上传,也就没有一台服务器替你干活,于是解码、比对和渲染全都在浏览器标签页里完成,而这个标签页同时还得让界面用起来不卡。
下面写的是这条约束的实际代价,以及网站其余部分是用什么搭起来的。
本页内容
解复用器得自己写
WebCodecs 提供了 VideoDecoder,它负责把编码块解成帧,但它不负责把编码块交给你。浏览器内部有一个 MP4 解析器——`<video>` 用的就是它——却没有任何 API 把这个解析器交出来。所以容器只能你自己解析:遍历 box、找到 moov、读采样表,再把 EncodedVideoChunk 一块一块喂给解码器。
这么做有个额外好处。既然容器是你自己读的,就能在用户白等五分钟之前告诉他这个文件为什么打不开:ProRes 是剪辑格式,浏览器一概解不了;而这件事是从它的 moov 里读出来的,ProRes 的 moov 又经常放在文件末尾而不是开头。我们的探测器头尾都扫,就是为了这个。
为什么要分成扫描和抓取两趟
最省事的做法是把每一帧都解码出来逐帧比对。可是一段 92 分钟、25fps 的录像有 138,000 帧,1080p 下这些帧标签页装不下。
所以引擎分两趟跑。第一趟是扫描:它只在采样点上解码,每个采样存成 160×90——小到整段视频的像素加起来只有几十兆,大到仍然能看出这一页和上一页不一样。等检测器挑完,第二趟抓取才回头去取全分辨率的帧,而且只取被挑中的那几个采样点。扫描最多取 900 个采样点,于是有了一个值得知道的结论:**29 分钟的视频和 92 分钟的视频,花的时间差不多**,因为成本是按采样点算的,不按分钟算。
一个分片一个 worker,各带一个解码器
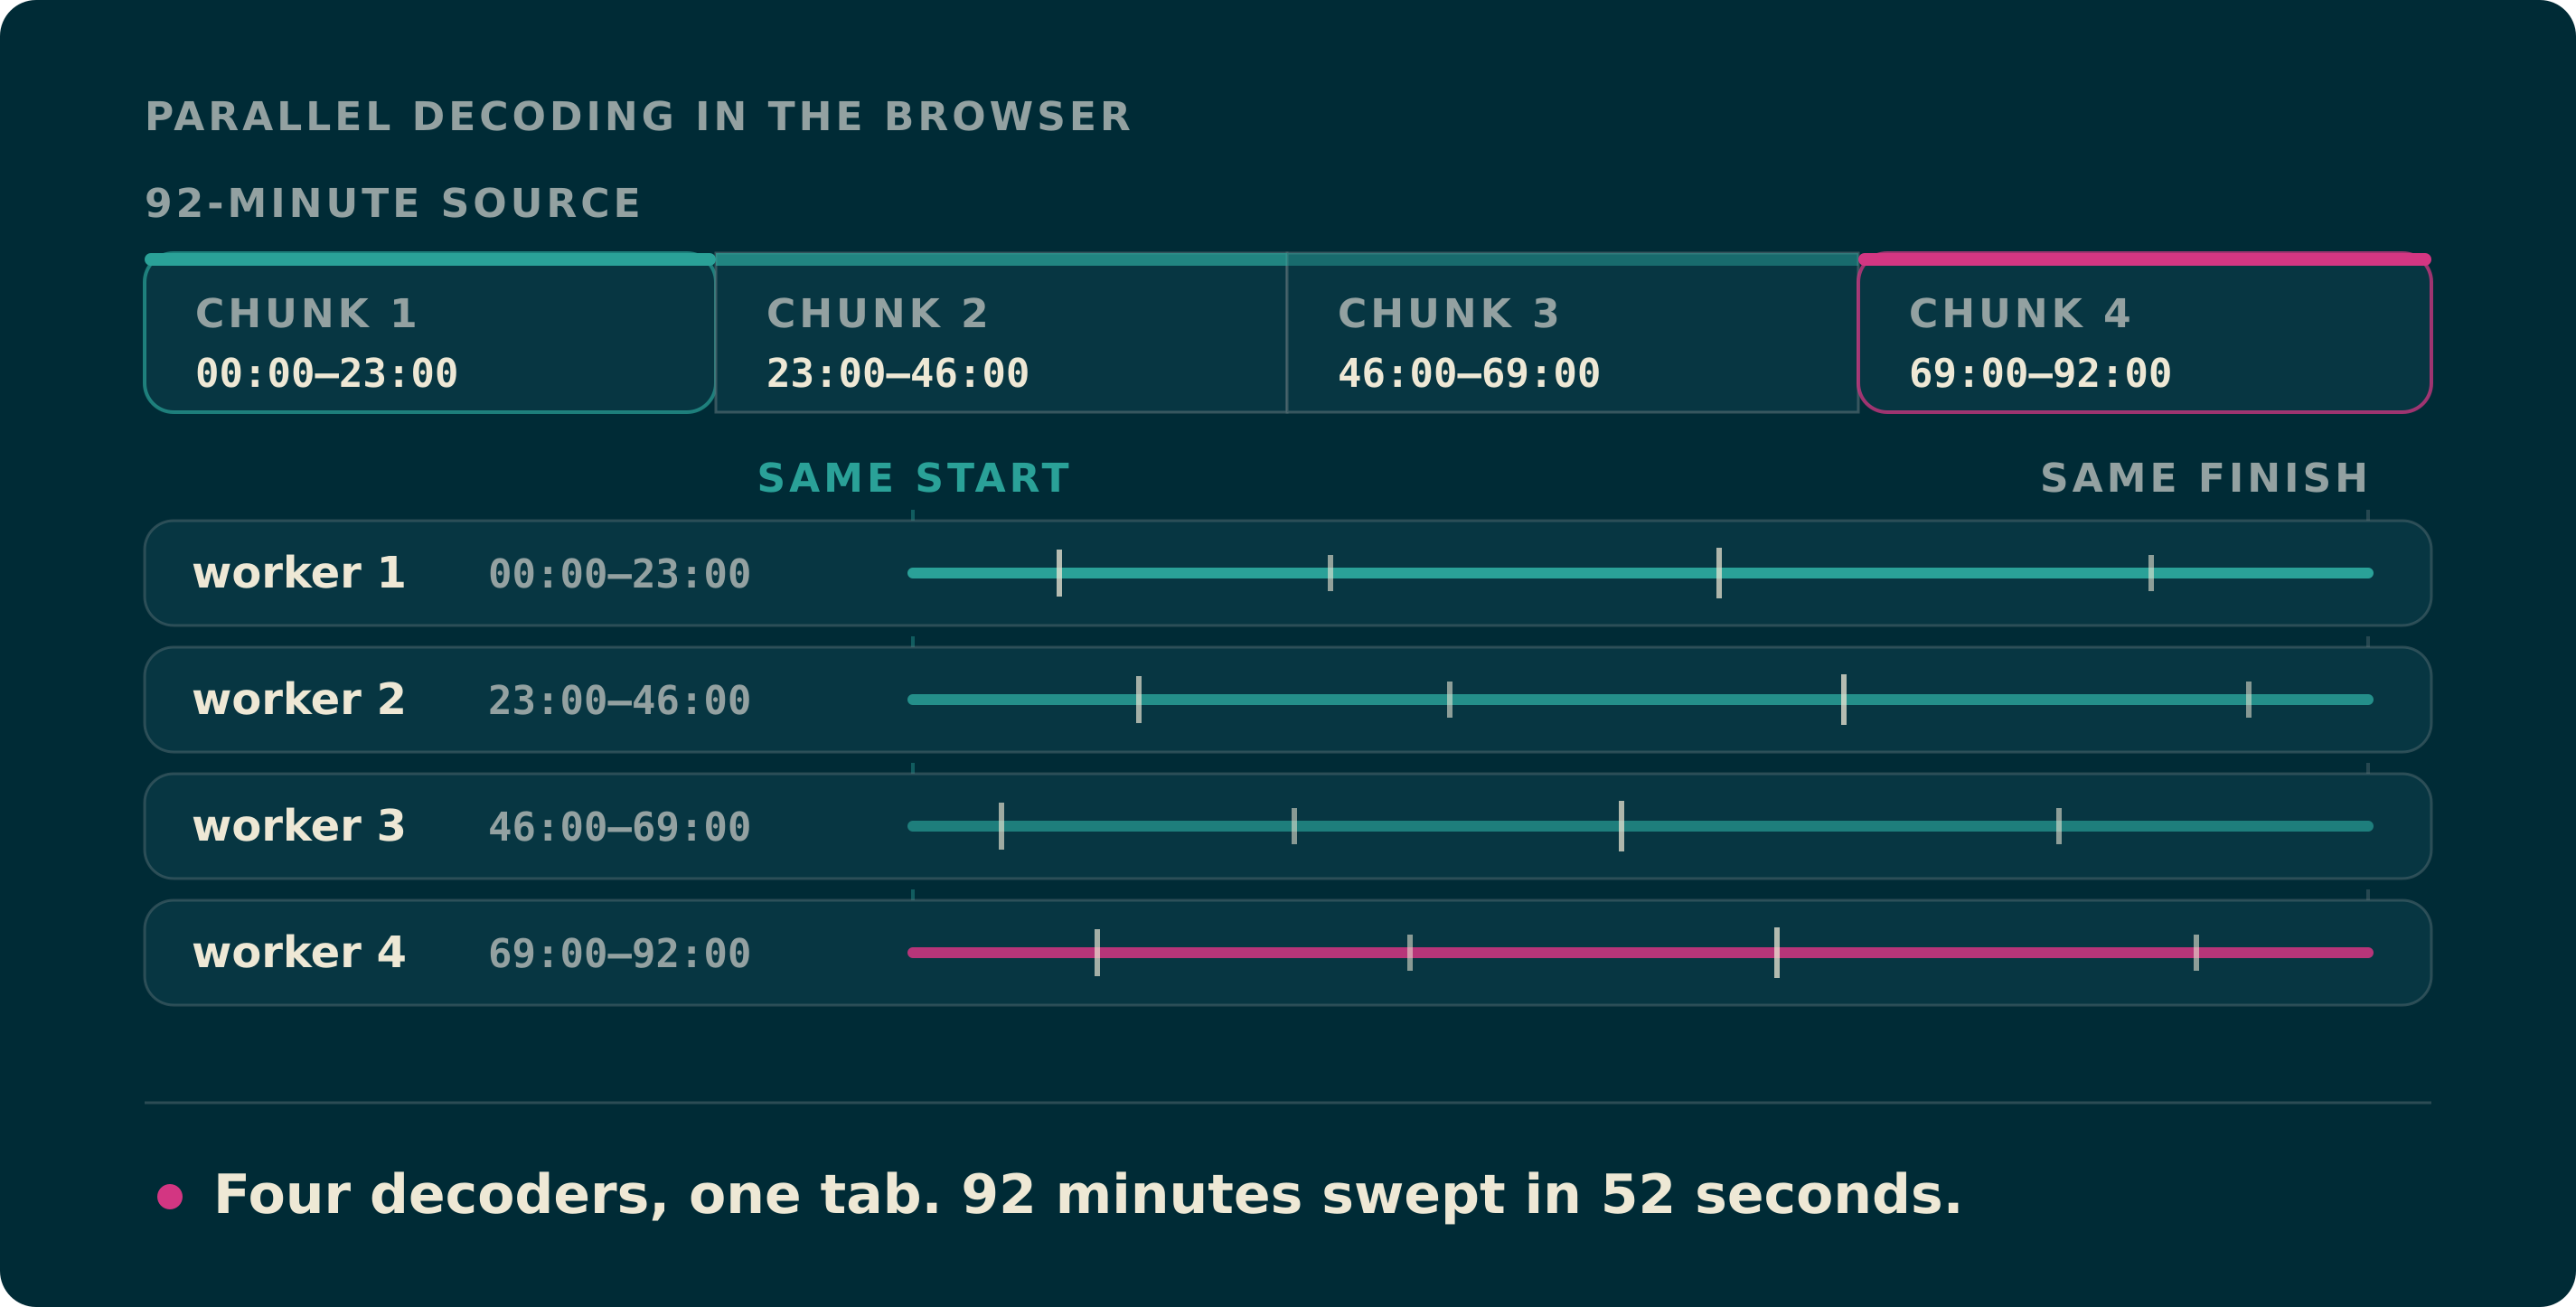
视频按时间切开,每个分片交给一个 worker,各自持有一个 VideoDecoder。池子大小是 min(4, 核数 / 2):只用一半的核,因为标签页还得跑界面;上限是 4,原因在下一节。
每个分片会从自己范围之前一点开始扫,好让检测器判断第一帧时手里有个参照,然后把不属于自己范围的结果丢掉。幻灯片是每抓到一张就送出一张,不是等全部跑完再一起给。
切分的代价
代价有两条。第一条:每个分片只在自己那一小段上标定检测阈值,所以同一个视频切成四片和切成八片,出来的幻灯片并不一样——**结果取决于这台机器有几个核**。第二条:每个分片只在自己内部去重,于是会议里反复切回的那个画面,在几个分片里出现过就会被保留几次。一段 29 分钟的录像,9 张里有 3 张是重复的。
去重这条已经修好:判定挪到了主线程,每张幻灯片一到就比一次。标定这条没修。我们把全局标定的版本写了出来,结果反而更差:还是那段会议,ffmpeg 数出 7 处真实转场,分片各自标定拿到 6 张,全局标定只拿到 4 张。所以池子上限仍然是 4——再多切几片大约能快 25%,但答案也会跟着变。
读完之前,一张都给不出来
阈值来自整段视频帧间差分的分布,所以在最后一帧被采样之前,第一张幻灯片也选不出来。扫描一段 92 分钟的录像要 52 秒,第一张幻灯片出现在第 50 秒。
这不是性能问题,加多少并行都解决不了;这是反馈问题。我们的解法是把原来那个孤零零的百分比换成「正在读取视频 · 45:46 / 92:08」。
其余的技术栈
API 跑在 Cloudflare Workers 上,框架用 Hono;账号和元数据存在 D1,少数几样真正需要存的东西放在 R2。前端是 React 19 配 TanStack Router、Tailwind v4 和 better-auth。八种语言,每种有自己的 URL 前缀和自己的路由 basepath。
整站是**预渲染的 SPA**,不是服务端渲染:每个公开页面都是部署时生成的静态 HTML 快照,营销页因此可以缓存、打开也快,转换器本身则完全不需要服务器。只有一个地方例外。`/app` 下面那些页面是静态壳子,编辑器启动时对你的账号一无所知,只能先发一次请求去问;而它在答案回来之前就开了工,一位付费订阅用户因此被按免费档限制到了三十分钟。worker 返回这些页面时本来就握着 session,所以现在它把套餐直接写进文档,第一次渲染就知道你是哪一档。这些响应是私有的,永不缓存;其他页面的公开缓存一点没动。
何必呢
换成服务器来跑,上面这些麻烦大半就没了。但那也意味着每一节课、每一场内部会议、每一段医疗录像都要从我们的机器上过一遍,而这个产品存在的全部理由,就是它们不用过这一遍。
这条约束本身就是产品要卖的东西,上面写的都是为它付出的代价。