Decodificar vídeo em paralelo dentro de uma aba
O Video2Any parte de uma restrição que decide todo o resto: o seu vídeo não sai da sua máquina. Como você não envia o arquivo, não existe servidor fazendo o trabalho por você, e é o navegador que decodifica, compara e renderiza — tudo dentro de uma aba que ainda precisa continuar respondendo.
Aqui está o que essa restrição custa de verdade, e com o que o resto do site foi construído.
Nesta página
O demuxer você escreve
O WebCodecs te dá um VideoDecoder que transforma trechos codificados em quadros, mas não te dá os trechos. O navegador tem um parser de MP4 por dentro — é assim que o <video> funciona — e nenhuma API entrega esse parser, então o contêiner você lê na mão: percorre as boxes, acha o moov, lê a tabela de amostras e passa um EncodedVideoChunk de cada vez para o decodificador.
Ler o contêiner traz uma vantagem extra. Já que você está percorrendo ele, dá para avisar que um arquivo não vai abrir antes que alguém perca cinco minutos esperando: ProRes é formato de edição que navegador nenhum decodifica, e quem conta isso é o moov, que no ProRes costuma ficar no fim do arquivo e não no começo. É por isso que a nossa sonda varre as duas pontas.
Varrer primeiro e capturar depois, por causa da memória
O óbvio seria decodificar todos os quadros e comparar. Só que uma gravação de 92 minutos a 25fps são 138.000 quadros e, em 1080p, uma aba não segura essa quantidade.
Por isso o motor trabalha em duas passadas. A primeira é a varredura: ela decodifica só os pontos de amostragem e guarda cada amostra em 160×90, um tamanho pequeno o bastante para o vídeo inteiro caber em algumas dezenas de megas de pixels e grande o bastante para distinguir um slide do seguinte. Depois que o detector escolhe, a segunda passada, a de captura, volta para pegar os quadros em resolução cheia — e só os escolhidos. A varredura não passa de 900 amostras, e desse teto sai uma conclusão que vale conhecer: um vídeo de 29 minutos e um de 92 custam quase o mesmo, porque o custo é por amostra e não por minuto.
Um worker por pedaço, cada um com seu decodificador
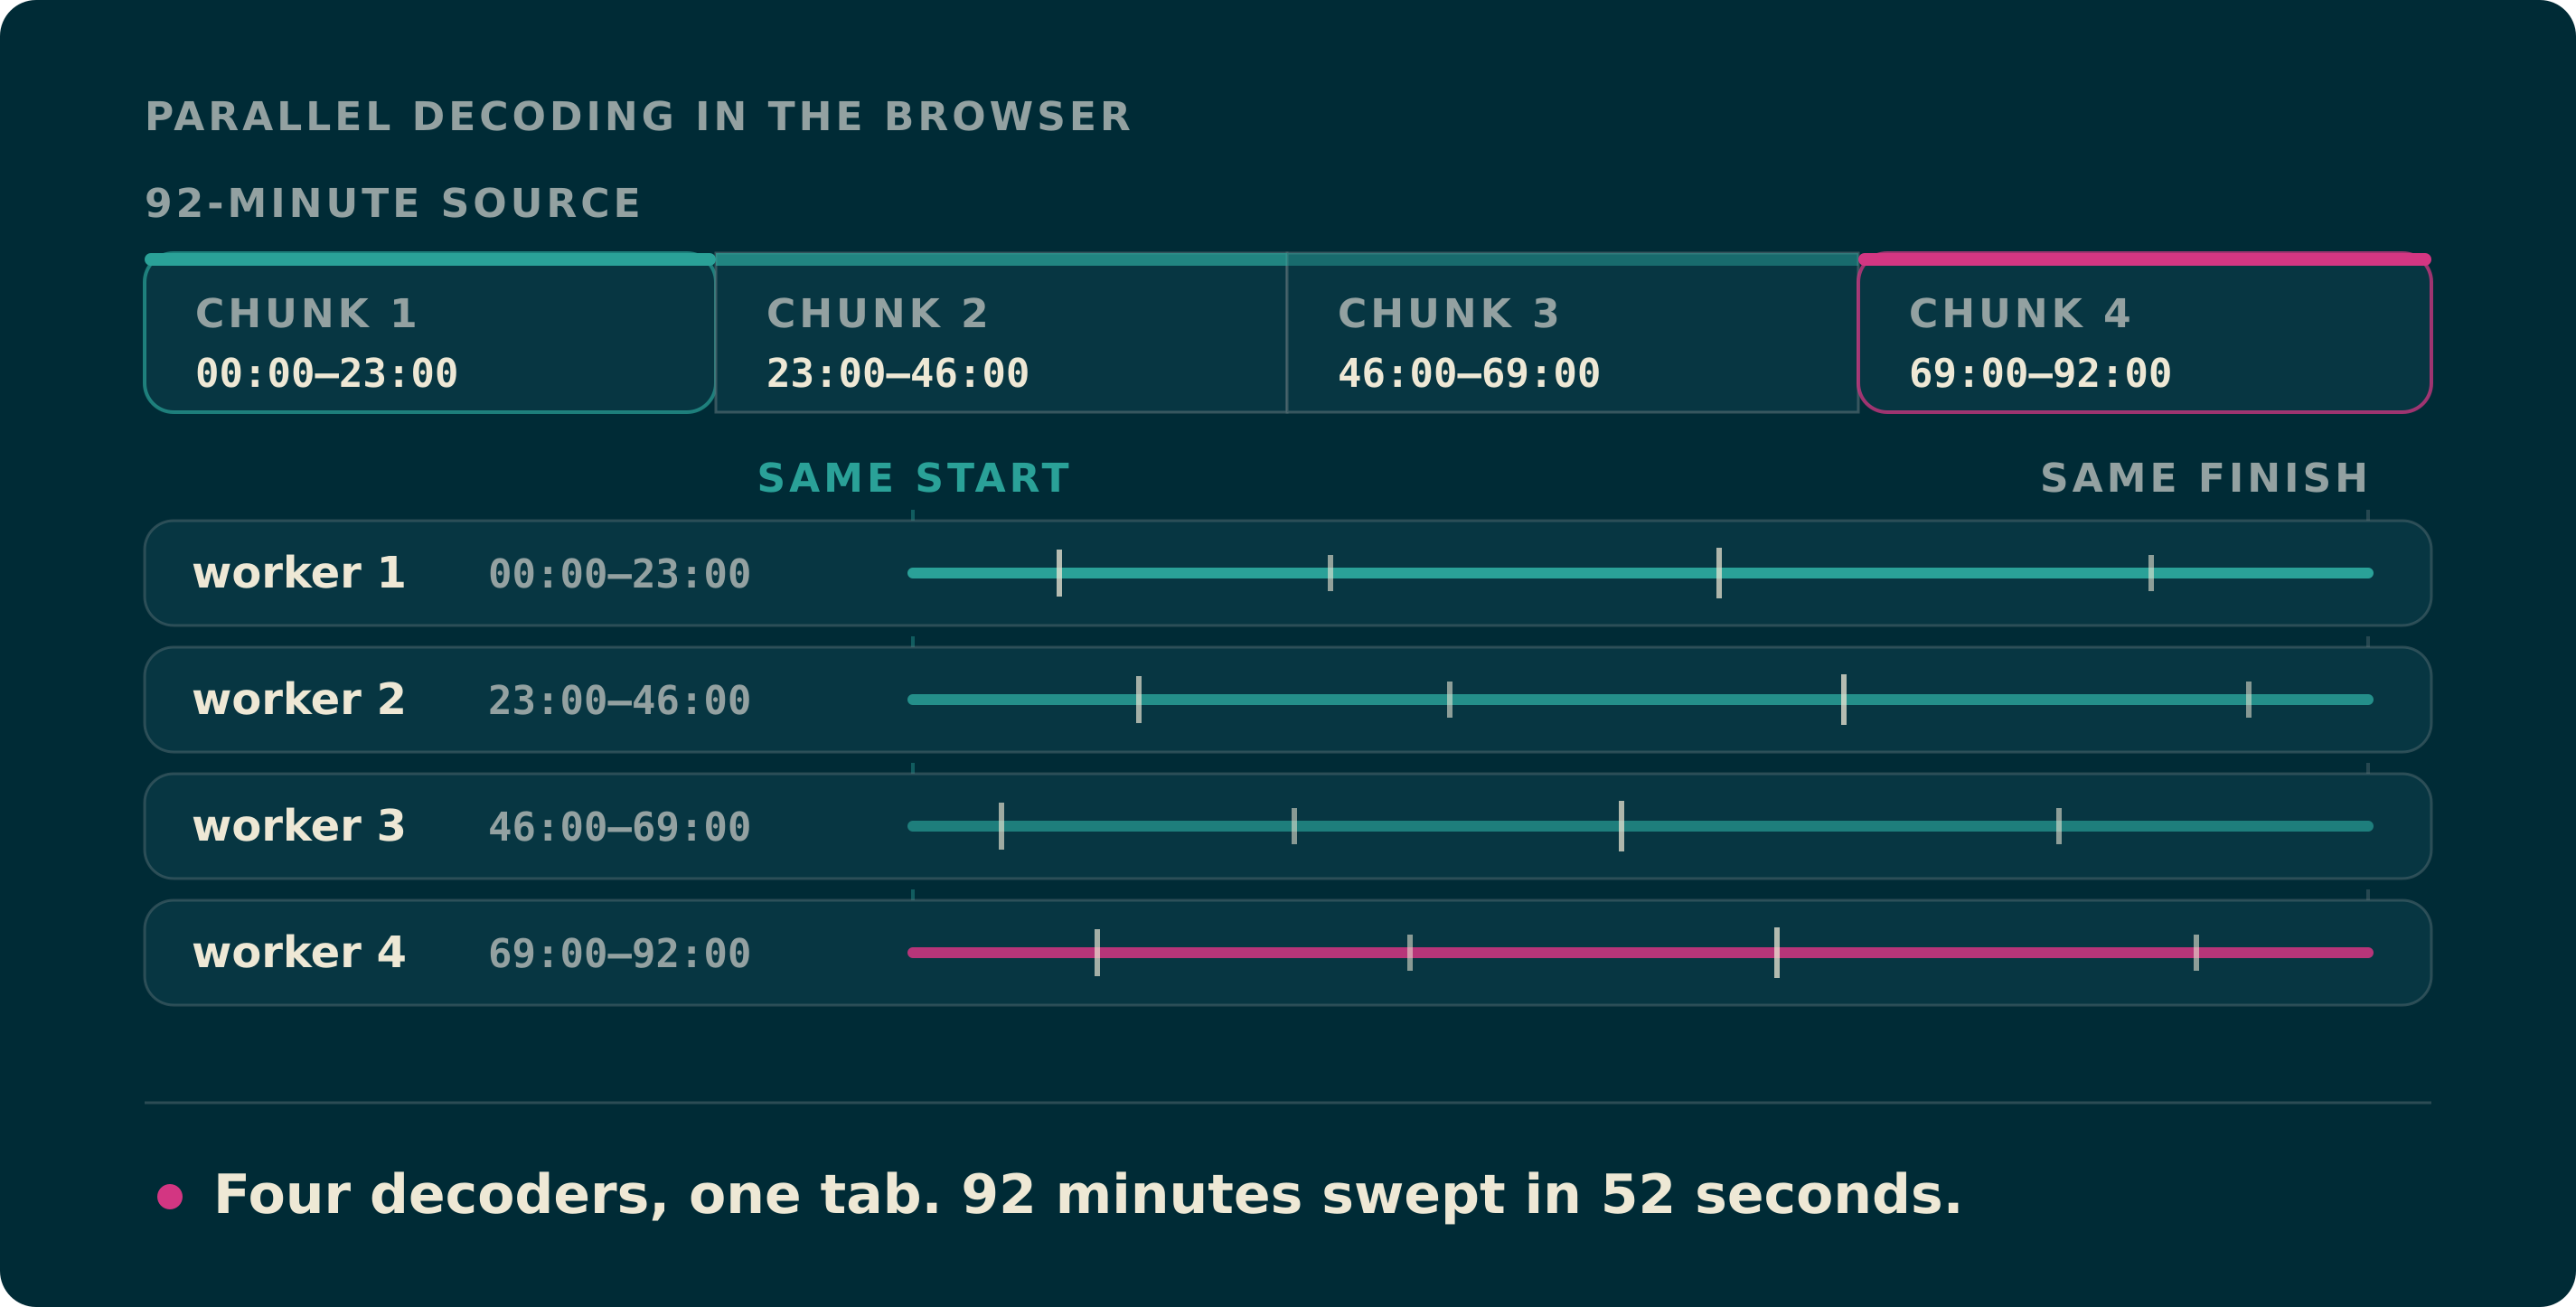
O motor corta o vídeo por tempo e entrega cada pedaço a um worker com seu próprio VideoDecoder. O pool é min(4, núcleos / 2): usamos metade dos núcleos porque a aba ainda tem uma interface para mexer, e paramos em quatro pelo motivo da próxima seção.
Cada pedaço começa a varrer um pouco antes do próprio intervalo, para o detector ter com o que comparar o primeiro quadro, e depois descarta o que cai fora do que é dele. Os slides vão saindo conforme cada captura termina, não todos juntos no fim.
O preço de fatiar
Fatiar custa duas coisas, e é aí que fica interessante. A primeira: cada pedaço calibra o limiar no próprio trecho, então o mesmo vídeo cortado em quatro e em oito gera apresentações diferentes, ou seja, o resultado depende de quantos núcleos a máquina tem. A segunda: cada pedaço tirava duplicatas só dentro de si, então uma cena para a qual a reunião volta o tempo todo sobrevivia uma vez em cada pedaço em que apareceu. Numa gravação de 29 minutos, três slides de nove estavam repetidos.
As duplicatas já estão resolvidas: a checagem foi para a thread principal e roda conforme cada slide chega. A calibração não. Escrevemos a versão global e o resultado piorou: na mesma reunião, onde o ffmpeg conta sete cortes reais, calibrar por pedaço acha seis e calibrar globalmente acha quatro. Por isso o pool continua em quatro: fatiar mais é uns 25% mais rápido, mas também muda a resposta.
Nada aparece antes de o vídeo ser lido inteiro
O limiar vem da distribuição das diferenças entre quadros do vídeo inteiro, então o detector não consegue escolher o primeiro slide antes de amostrar o último quadro. Numa gravação de 92 minutos a varredura leva 52 segundos e o primeiro slide aparece no segundo 50.
Isso não é problema de desempenho e nenhum grau de paralelismo resolve: é problema de informação. A gente resolveu escrevendo "Lendo o vídeo · 45:46 de 92:08" onde antes havia só uma porcentagem.
O resto da stack
A API roda em Cloudflare Workers com Hono, as contas e os metadados ficam no D1, e as poucas coisas que precisam ser guardadas vão para o R2. O front é React 19 com TanStack Router, Tailwind v4 e better-auth. Oito idiomas, cada um com seu prefixo de URL e seu basepath de router.
O site é uma SPA pré-renderizada em vez de renderizada no servidor: cada página pública é um snapshot de HTML estático gerado no deploy, e por isso as páginas de marketing são cacheáveis e rápidas enquanto o conversor funciona sem servidor algum. A gente quebra essa regra em exatamente um lugar. As páginas /app são cascas estáticas, então o editor começava sem saber nada da sua conta e precisava perguntar; como ele começava a trabalhar antes de a resposta voltar, um assinante pagante acabou com o limite de trinta minutos do plano grátis. O worker já tem a sessão quando serve essas páginas, então agora ele escreve o plano no documento e a primeira renderização já sabe. Essas respostas são privadas e nunca são cacheadas; as outras páginas mantêm o cache público.
Por que se dar ao trabalho
Um servidor faria quase tudo isso sumir. Também significaria que toda aula, toda reunião interna e toda gravação médica que alguém converte passaria pelas nossas máquinas — e o produto existe justamente para que não passem.
A restrição não atrapalha o produto: ela é o produto. Tudo o que está acima é o que pagamos por ela.