Oito bugs que pareciam ser do algoritmo
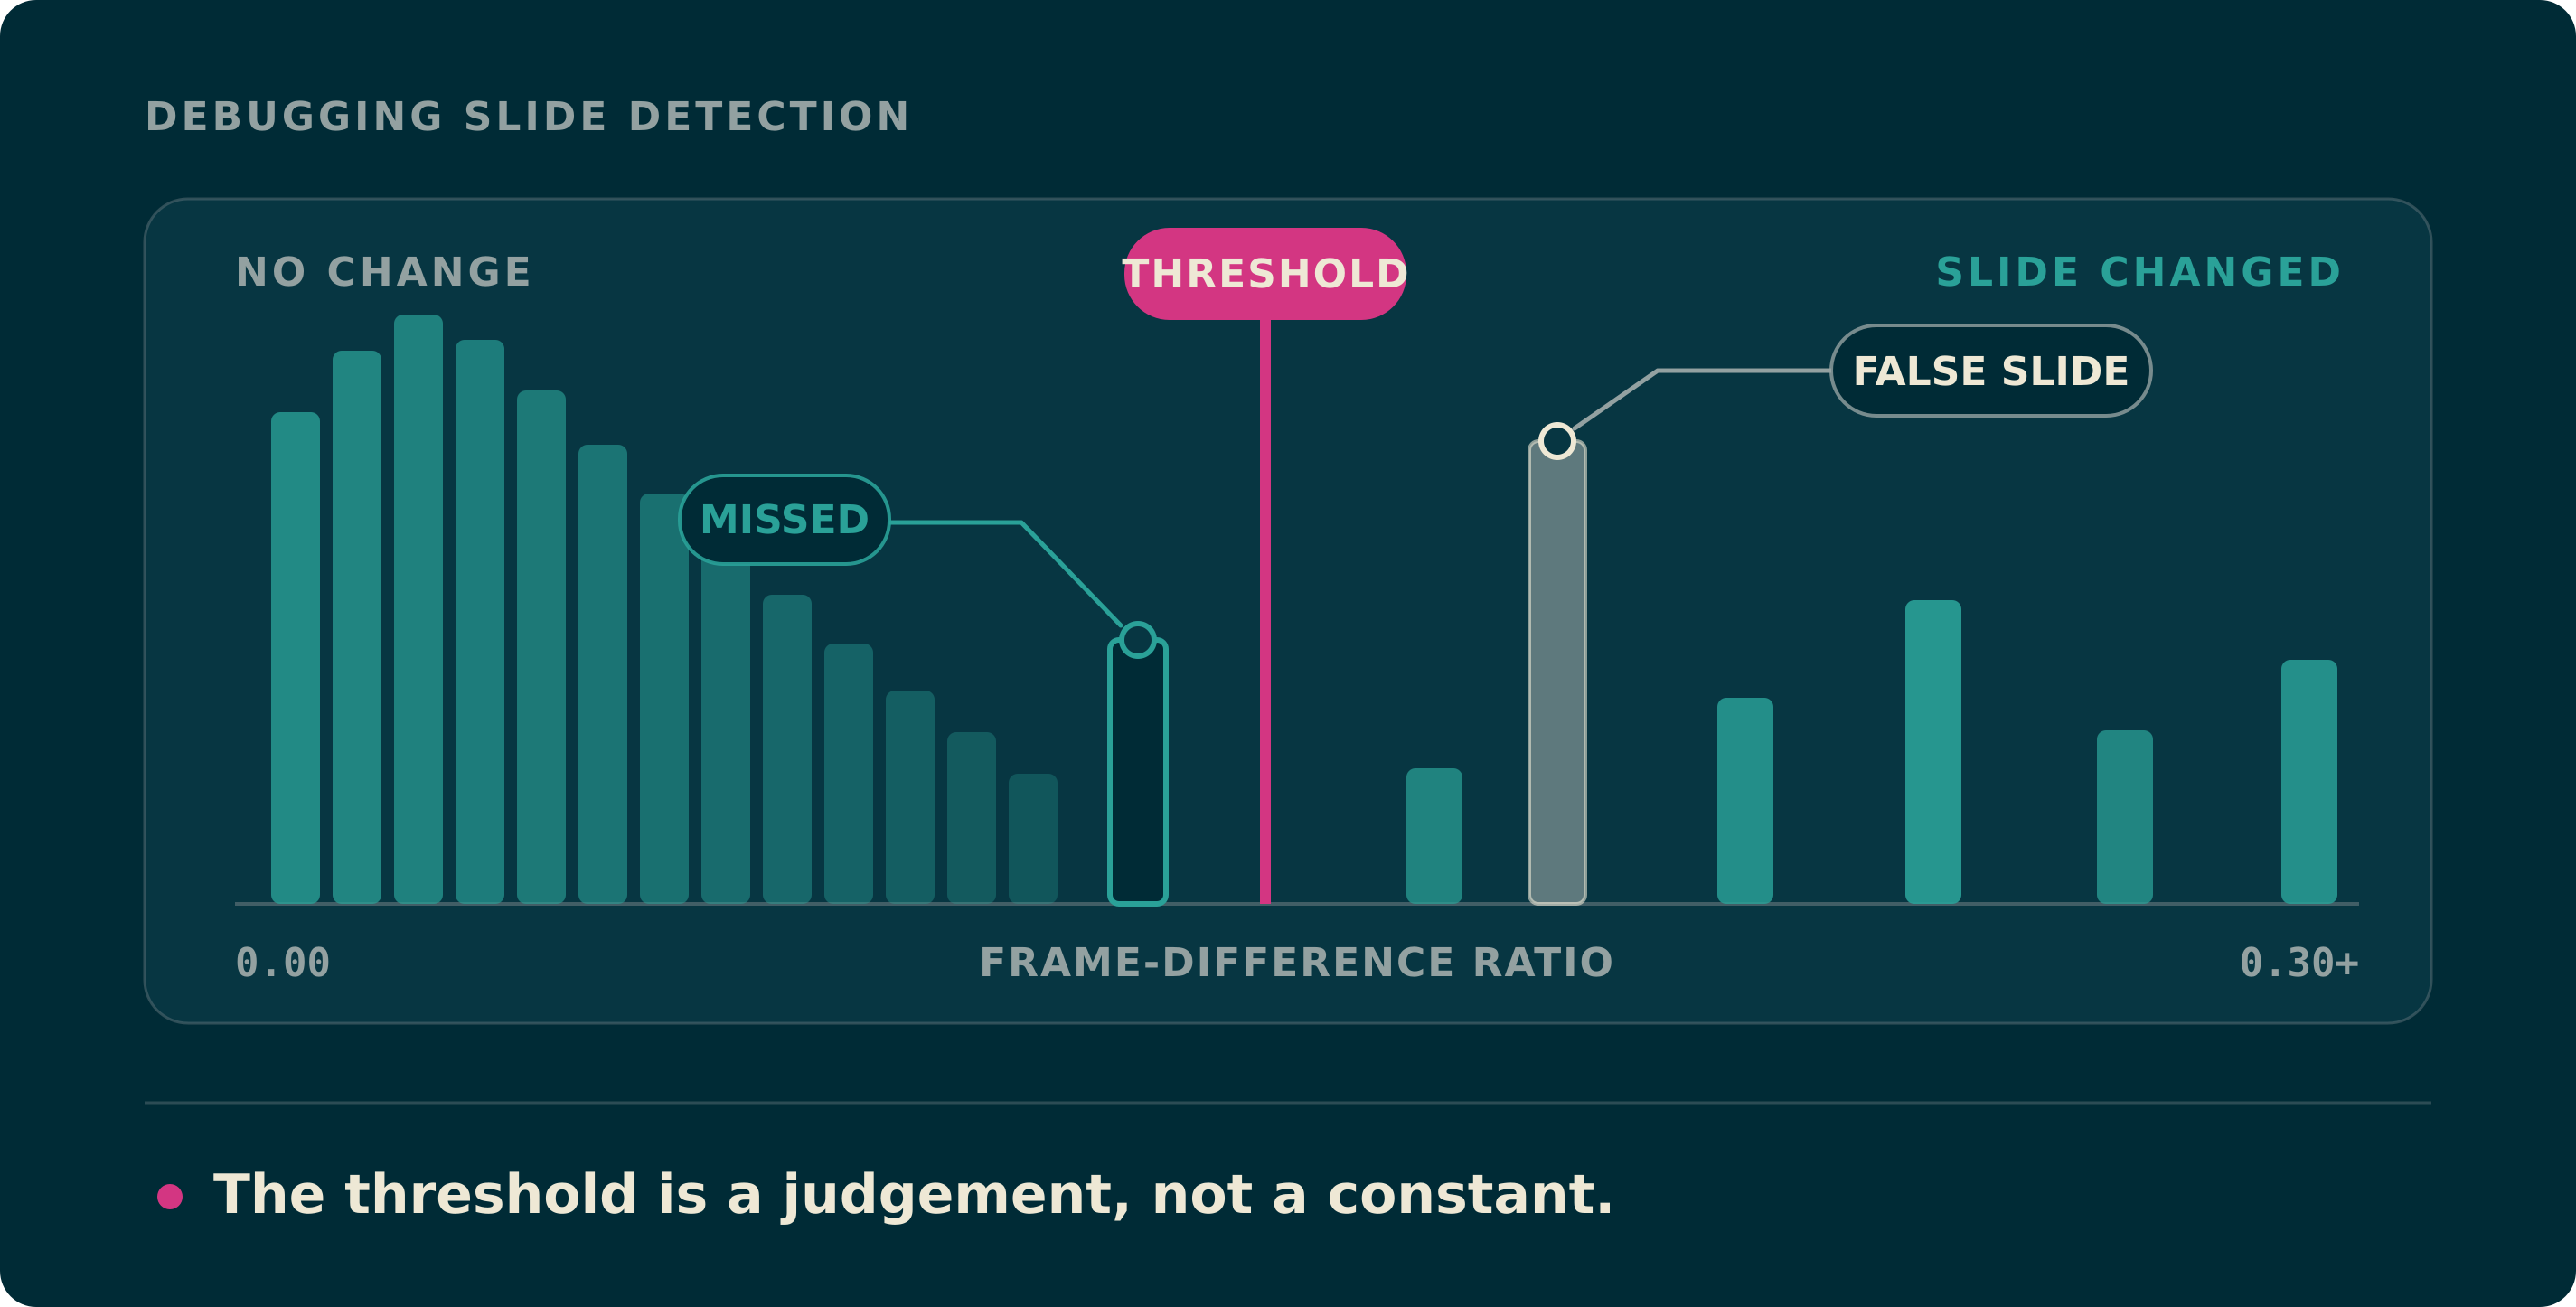
O Video2Any acha os slides de uma gravação decodificando quadros no navegador, comparando cada um com o anterior e guardando os que mudaram o suficiente. Quando o resultado sai errado, o suspeito óbvio é essa comparação. Quase nunca é ela.
São oito problemas que caçamos em uma semana. Só dois estavam no detector. Os outros seis foram uma guarda que ninguém tinha limpado, um script de teste que dava números errados, uma lista virtualizada, uma corrida com uma chamada de API, a memória chegando ao limite e um registro de erro. Esse registro guardava de cada erro justamente a parte que não servia para nada.
Os oito
1. O controle que não fazia nada
Chegou um relato de que um vídeo curto dava três slides no Denso, igual ao Padrão. Ficamos um tempo olhando a fórmula do limiar antes de checar o mais básico: esse ajuste chegava ao detector?
Não chegava. A primeira varredura é protegida por uma ref para rodar uma vez por arquivo. Trocar a densidade reconstruía o callback, mas a guarda devolvia o efeito na hora, e a única coisa que de fato reexecutava era um botão de um aviso sem relação nenhuma. O que você via depois de trocar o ajuste era o resultado anterior, com os mesmos timestamps. Agora, no mesmo clipe, Esparso, Padrão e Denso dão 3, 6 e 13. Antes os três davam 6.
2. O script de teste errou duas vezes
Para explicar um resultado estranho, refizemos o pipeline offline em Node e jogamos o arquivo real nele. Os números não bateram com o app, e nas duas vezes erraram para lados opostos: primeiro o script dizia 1 slide e o app 6; depois de corrigir, o script dizia 15 e o app 6.
As causas eram duas. O script tirava os quadros com ffmpeg em escala de cinza, enquanto o navegador entrega ao motor o RGBA de um canvas, e a diferença entre os dois redimensionamentos já move o limiar calibrado de 0,618 para 0,650. Além disso, o script pulava a função que decide se usa a máscara de atividade, então não passava pelo caminho por onde o app passa. Um script que reproduz o algoritmo mas não o pipeline te dá uma resposta errada com toda a convicção.
3. No DOM só tinha o que estava na tela
Um teste verificava se um vídeo de 32 minutos produzia slides depois dos 30. Ele lia o timestamp de todas as miniaturas e apontava o último em 27:00, exatamente a cara de uma análise truncada.
A grade é virtualizada: só as linhas visíveis existem como elementos. Rolando até o fim antes de ler, o último de verdade estava em 32:00. Essa asserção estava medindo o viewport, e não os dados, esse tempo todo.
4. Cada worker tirava duplicatas sozinho
Vídeos longos são varridos em pedaços paralelos. Cada worker descarta as cenas repetidas dentro do seu próprio pedaço — alguém voltando para um slide anterior, uma chamada cortando de volta para o mesmo enquadramento — e nenhum worker enxerga o que os outros fizeram.
Então uma cena que reaparecia sobrevivia uma vez por pedaço em que aparecia. Numa reunião de 29 minutos, eram três slides duplicados de nove. E o resultado passava a depender de quantos pedaços existiam, ou seja, de quantos núcleos a máquina de quem usa tem. Levamos a checagem para a thread principal, onde ela roda conforme cada slide chega, então uma duplicata nunca chega a aparecer para depois sumir.
5. O design mais certo deu o pior resultado
Cada pedaço calibrar o próprio limiar no próprio trecho não faz sentido: um vídeo, uma distribuição, um limiar. Então escrevemos assim. Os workers mandam as proporções que mediram, a thread principal junta tudo, calibra uma vez e devolve a resposta.
A diferença entre quatro pedaços e oito caiu de três slides para um. E o resultado piorou. Na mesma reunião de 29 minutos, onde a detecção de cenas do próprio ffmpeg conta sete cortes reais, calibrar por pedaço mais a deduplicação acima dá seis e calibrar globalmente dá quatro. Ao juntar as proporções a distribuição alarga, a mediana mais dois MAD sobe e transições de verdade caem fora. Revertemos a mudança. Um design pode ser mais correto e ainda assim perder para o que você já tem, e para enxergar isso você precisa de algo fora do seu código para comparar.
6. Falso porque a gente ainda não tinha perguntado
Um assinante pagante subiu uma gravação longa e recebeu só os primeiros trinta minutos. Apertando Reamostrar vinha inteira, e é justamente isso que fazia aquilo parecer problema de detecção.
O editor começa antes de saber quem é você. A flag de assinatura começa falsa, e esse falso não quer dizer que a resposta foi não: quer dizer que a requisição ainda estava a caminho. O limite de duração leu esse falso e aplicou o teto do plano grátis. Quando a reamostragem rodava, o plano já tinha chegado. Primeiro consertamos esperando a resposta; depois tiramos a espera: o worker já tem a sessão na hora de servir a página, então escreve o plano no documento e a primeira renderização já sabe.
7. Todo erro se chamava “Error”
A transcrição falhava mais do que funcionava, seis falhas contra cinco sucessos, e todas eram registradas como a string “Error”. As dezenove extrações que falharam, idem.
O código gravava err.name, que vale “Error” para qualquer erro construído na mão. A mensagem, que é onde a informação sempre esteve, não ia para lugar nenhum. Quando passamos a gravá-la, entendemos o que acontecia: decodeAudioData reamostra para a taxa do contexto de áudio, então decodificar uma aula de 55 minutos nos 48 kHz estéreo do hardware reserva uns 630 MB de amostras em ponto flutuante antes de qualquer outra coisa, e duas horas dão 1,4 GB. Decodificando num contexto que já está em 16 kHz, o modelo recebe o mesmo áudio com cerca de um sexto da memória.
8. Era rápido e mesmo assim parecia quebrado
Uma gravação de reunião de 92 minutos é varrida em 52 segundos. O primeiro slide aparece no segundo 50.
Não havia nada lento. O limiar é calibrado a partir da distribuição inteira das diferenças entre quadros, então nenhum slide pode ser escolhido antes de o vídeo ser lido do começo ao fim, e nesses 50 segundos a única coisa na tela era uma porcentagem. Quando um número sobe sozinho e não há mais nada ao lado, quem está olhando entende que o programa travou. Agora a tela diz qual metade do trabalho está rodando e quanto do vídeo já foi lido, e os mesmos 52 segundos deixaram de gerar reclamação.
O que a gente diria para quem éramos uma semana atrás
Confirme que a entrada chegou no código antes de raciocinar sobre o código. Metade destes casos foram ajustes que nunca chegaram, respostas que ainda não tinham voltado ou um teste olhando para outra coisa.
E mantenha algo fora do seu pipeline para comparar. A detecção de cenas do ffmpeg não é o que estamos construindo e nem precisa ser: basta ser independente do nosso código. Sem ela teríamos publicado a reescrita da calibração, porque era o design melhor, e teríamos perdido sem perceber três slides reais de sete.