Décoder une vidéo en parallèle dans un seul onglet
Video2Any repose sur une contrainte qui décide de tout le reste : votre vidéo ne quitte pas votre machine. Comme vous n’envoyez aucun fichier, aucun serveur ne travaille à votre place, et c’est le navigateur qui décode, compare et fabrique le résultat, dans un onglet qui doit en plus rester réactif.
Voici ce que cette contrainte coûte réellement, et avec quoi le reste du site est construit.
Sur cette page
Le démultiplexeur, c’est à vous de l’écrire
WebCodecs vous donne un VideoDecoder, qui transforme des morceaux encodés en images, mais il ne vous donne pas les morceaux. Le navigateur contient un parseur MP4 — c’est ainsi que <video> fonctionne — et aucune API ne vous le confie : vous lisez donc le conteneur vous-même. Vous parcourez les boîtes, vous trouvez moov, vous lisez la table des échantillons, et vous passez au décodeur un EncodedVideoChunk à la fois.
Lire le conteneur soi-même apporte un avantage supplémentaire. Puisque vous le parcourez déjà, vous pouvez annoncer qu’un fichier ne s’ouvrira pas avant que quelqu’un perde cinq minutes à attendre : ProRes est un format de montage qu’aucun navigateur ne décode, et c’est son moov qui le dit — un moov qui, chez ProRes, se trouve souvent à la fin du fichier plutôt qu’au début. C’est pour cela que notre sonde examine les deux extrémités.
Un balayage puis une capture, à cause de la mémoire
L’approche évidente serait de décoder toutes les images et de les comparer. Mais un enregistrement de 92 minutes à 25 i/s représente 138 000 images, et en 1080p un onglet ne peut pas les garder.
Le moteur procède donc en deux passes. La première, le balayage, ne décode que les points d’échantillonnage et conserve chaque échantillon en 160×90 : assez petit pour qu’une vidéo entière tienne en quelques dizaines de mégaoctets de pixels, assez grand pour distinguer une diapositive de la suivante. Une fois que le détecteur a choisi, la seconde passe, la capture, revient chercher les images en pleine résolution, et seulement celles qu’il a retenues. Le balayage ne dépasse jamais 900 échantillons, et ce plafond entraîne une conséquence curieuse : une vidéo de 29 minutes et une de 92 coûtent à peu près le même temps, parce que le coût se compte par échantillon et non par minute.
Un worker par morceau, chacun avec son décodeur
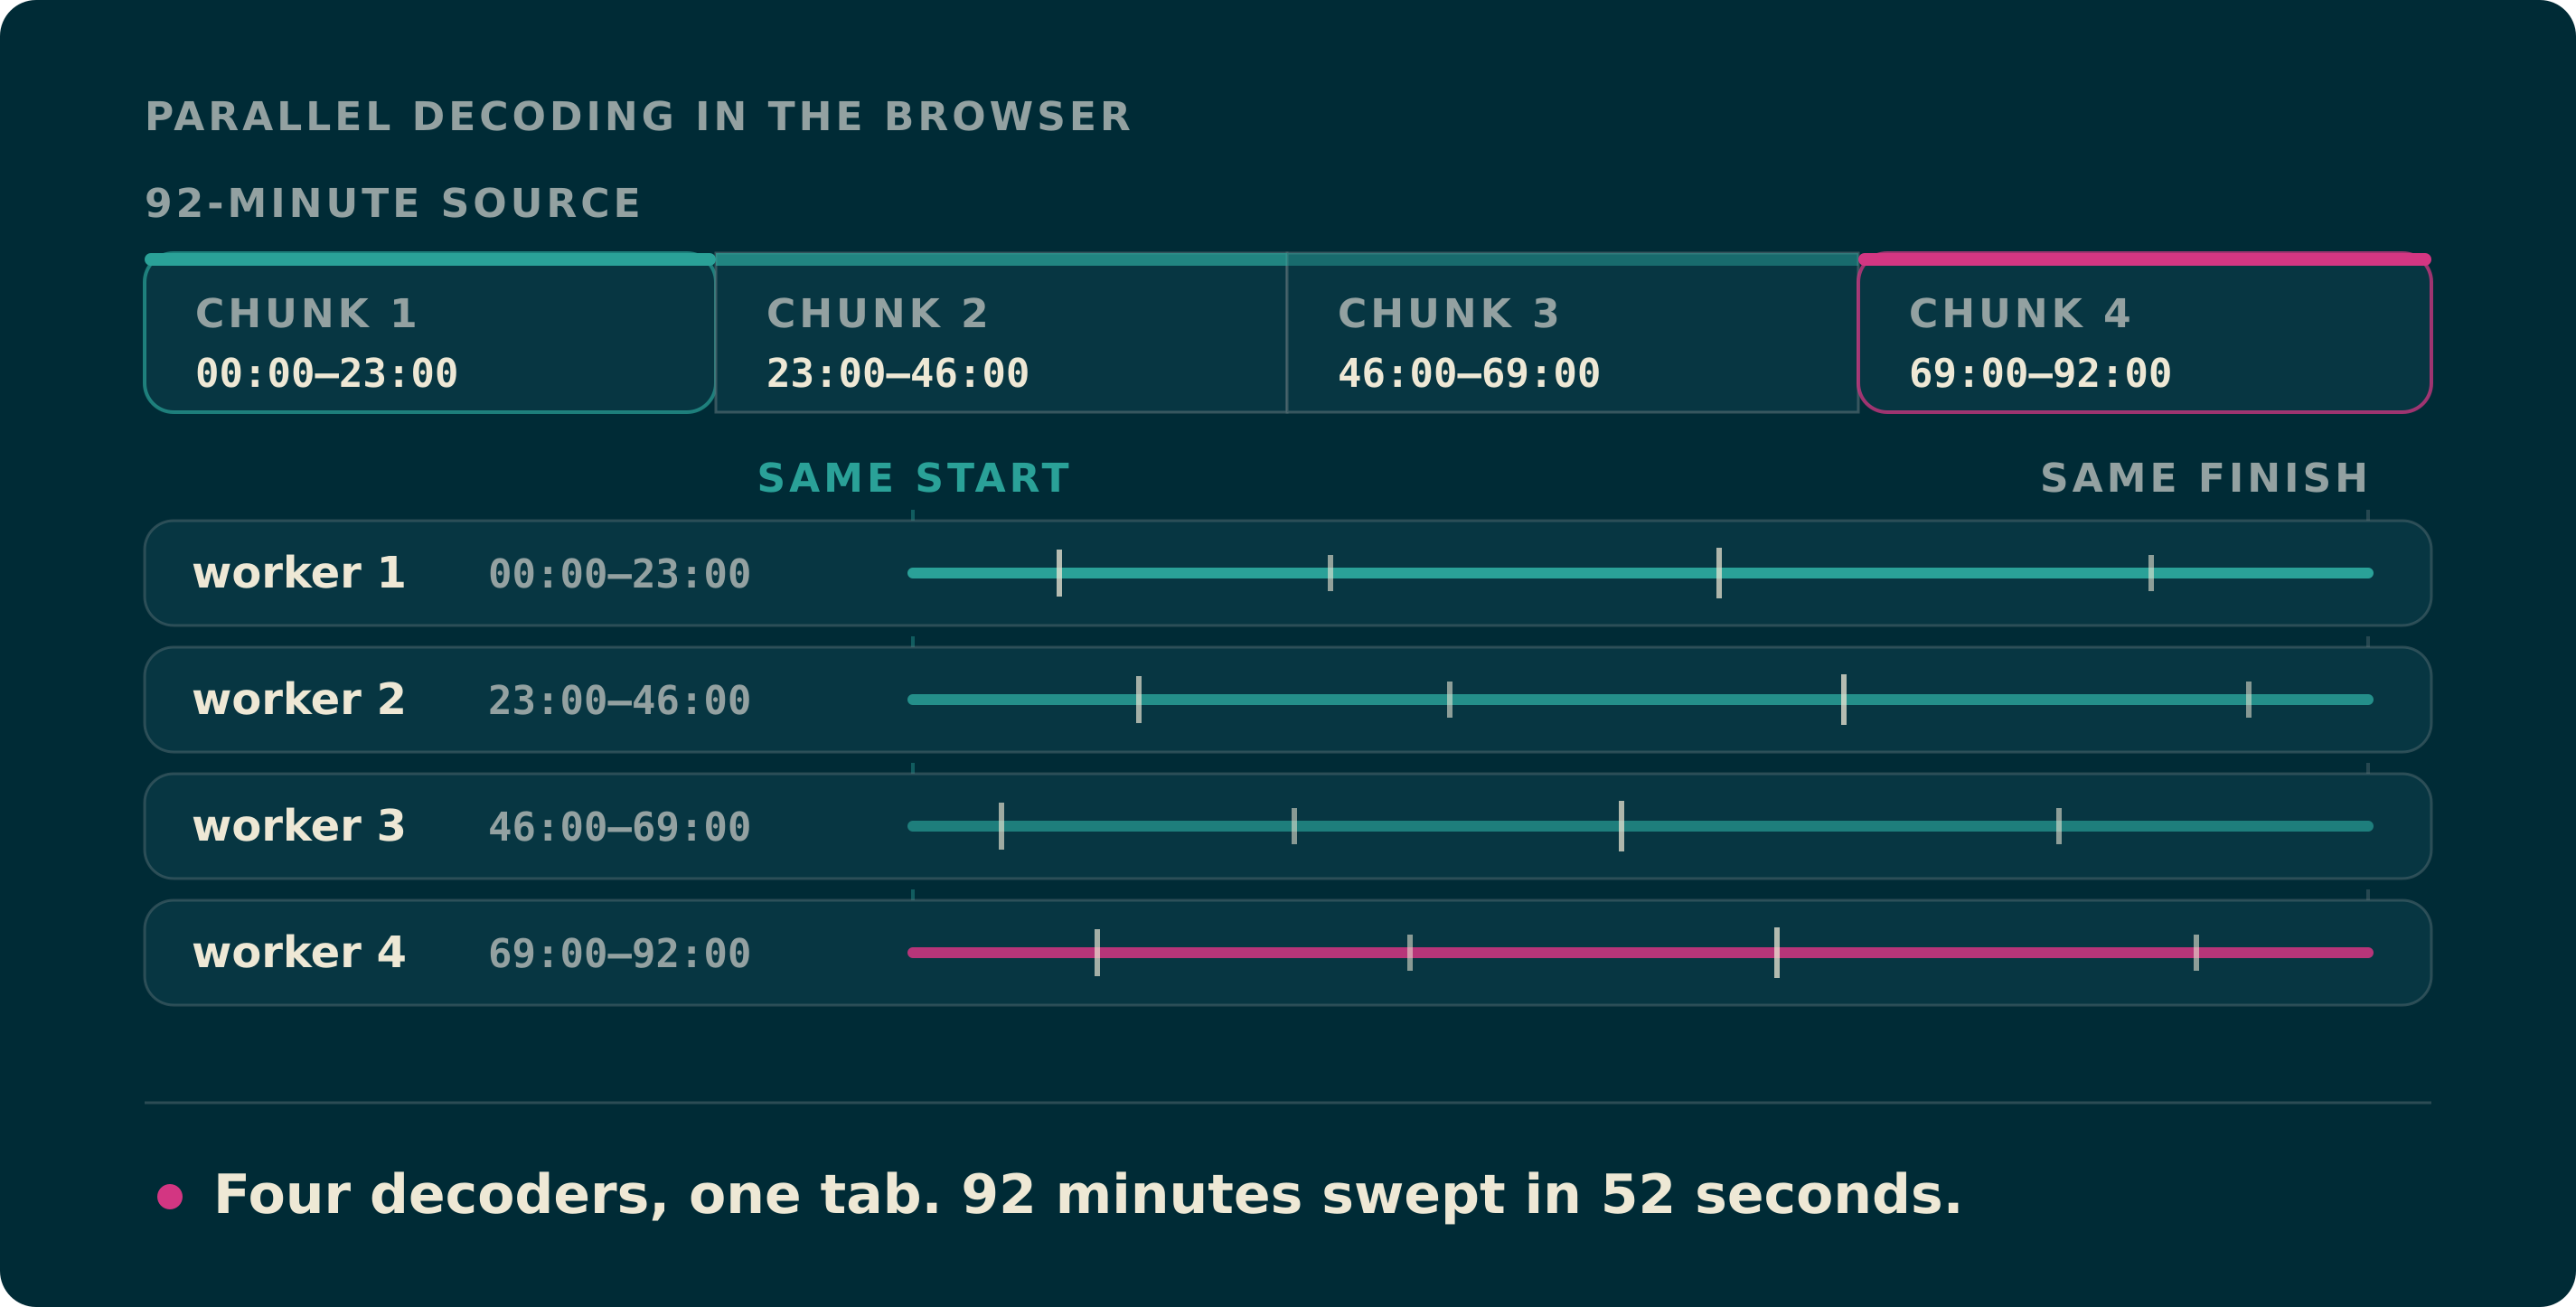
Le moteur découpe la vidéo dans le temps et confie chaque morceau à un worker doté de son propre VideoDecoder. Le pool vaut min(4, cœurs / 2) : nous n’utilisons que la moitié des cœurs, parce que l’onglet a encore une interface à faire tourner, et nous plafonnons à quatre pour la raison exposée à la section suivante.
Chaque morceau commence à balayer un peu avant sa propre plage, pour que le détecteur ait de quoi juger sa première image, puis il écarte ce qui tombe hors de sa plage. Les diapositives sortent au fil des captures, et non toutes ensemble à la fin.
Ce que coûte le découpage
Le découpage coûte deux choses, et c’est là que cela devient intéressant. D’abord, chaque morceau calibre son seuil sur sa propre tranche : la même vidéo découpée en quatre et en huit donne des présentations différentes, autrement dit le résultat dépend du nombre de cœurs de la machine. Ensuite, chaque morceau ne supprimait les doublons qu’en son sein : un plan sur lequel une réunion revient sans cesse survivait une fois par morceau où il apparaissait. Sur un enregistrement de 29 minutes, trois diapositives sur neuf faisaient double emploi.
Les doublons sont réglés : la vérification est passée sur le thread principal et s’exécute à mesure que les diapositives arrivent. Le calibrage, lui, ne l’est pas. Nous avons écrit la version globale et le résultat s’est dégradé : sur cette même réunion, où ffmpeg compte sept coupes réelles, le calibrage par morceau en trouve six et le calibrage global quatre. Le pool reste donc à quatre : découper davantage va environ 25 % plus vite, mais change aussi la réponse.
Rien ne peut être montré avant d’avoir lu toute la vidéo
Le seuil vient de la distribution des différences entre images sur l’ensemble de la vidéo : le détecteur ne peut donc pas choisir la première diapositive avant d’avoir échantillonné la dernière image. Sur un enregistrement de 92 minutes, le balayage prend 52 secondes et la première diapositive apparaît à la 50ᵉ.
Ce n’est pas un problème de performance, et aucun degré de parallélisme ne le règle : c’est un problème d’information. Nous l’avons traité en écrivant « Lecture de la vidéo · 45:46 sur 92:08 » là où ne s’affichait qu’un pourcentage.
Le reste de la pile
L’API tourne sur Cloudflare Workers avec Hono, les comptes et les métadonnées vivent dans D1, et les rares éléments que nous stockons vont dans R2. Le front repose sur React 19 avec TanStack Router, Tailwind v4 et better-auth. Huit langues, chacune avec son préfixe d’URL et son basepath de routeur.
Le site est une SPA prérendue plutôt que rendue côté serveur : chaque page publique est un instantané HTML statique produit au déploiement, ce qui rend les pages marketing rapides et cacheables pendant que le convertisseur fonctionne sans aucun serveur. Nous dérogeons à cette règle à un seul endroit. Les pages /app sont des coquilles statiques : l’éditeur démarrait donc sans rien savoir de votre compte et devait poser la question ; comme il commençait à travailler avant la réponse, un abonné payant s’est retrouvé avec la limite de trente minutes de l’offre gratuite. Le worker détient déjà la session lorsqu’il sert ces pages : il y inscrit désormais la formule, et le premier rendu la connaît. Ces réponses sont privées et ne sont jamais mises en cache ; toutes les autres pages conservent leur cache public.
Pourquoi s’embêter
Un serveur ferait disparaître l’essentiel de ce qui précède. Il signifierait aussi que chaque cours, chaque réunion interne et chaque enregistrement médical converti passerait par nos machines — et le produit existe précisément pour qu’ils n’y passent pas.
La contrainte n’est pas un obstacle : c’est le produit. Tout ce qui précède est ce que nous payons pour la tenir.