Decodificar video en paralelo dentro de una pestaña
Video2Any parte de una restricción que decide todo lo demás: tu video no sale de tu máquina. Como no subes el archivo, no hay ningún servidor que haga el trabajo por ti, así que el navegador decodifica, compara y renderiza dentro de una pestaña que además tiene que seguir respondiendo mientras tanto.
Aquí contamos lo que cuesta de verdad sostener esa restricción y con qué está construido el resto del sitio.
En esta página
El demuxer te toca escribirlo
WebCodecs te da un VideoDecoder que convierte fragmentos codificados en fotogramas, pero no te da los fragmentos. El navegador lleva dentro un parser de MP4 —así funciona <video>— y ninguna API te lo entrega, de modo que el contenedor lo lees tú: recorres las cajas, encuentras moov, lees la tabla de muestras y le pasas al decodificador un EncodedVideoChunk cada vez.
Leer el contenedor tiene una ventaja añadida. Como ya lo estás recorriendo, puedes avisar de que un archivo no se va a abrir antes de que alguien pierda cinco minutos esperando: ProRes es un formato de edición que ningún navegador decodifica, y quien lo cuenta es su moov, que en ProRes suele estar al final del archivo y no al principio. Por eso nuestra sonda mira los dos extremos.
Barrer primero y capturar después, por la memoria
Lo evidente sería decodificar todos los fotogramas y compararlos. Pero una grabación de 92 minutos a 25fps son 138.000 fotogramas y, a 1080p, una pestaña no puede sostener esa cantidad.
Por eso el motor trabaja en dos pasadas. La primera, el barrido, decodifica solo los puntos de muestreo y guarda cada muestra a 160×90: un tamaño lo bastante pequeño para que un video entero ocupe unas decenas de megas de píxeles y lo bastante grande para distinguir una diapositiva de la siguiente. Cuando el detector ya ha elegido, la segunda pasada, la de captura, vuelve a por los fotogramas a resolución completa, y solo por los elegidos. El barrido no pasa de 900 muestras, y de ese tope sale una conclusión que conviene conocer: un video de 29 minutos y uno de 92 tardan casi lo mismo, porque el coste va por muestra y no por minuto.
Un worker por trozo, cada uno con su decodificador
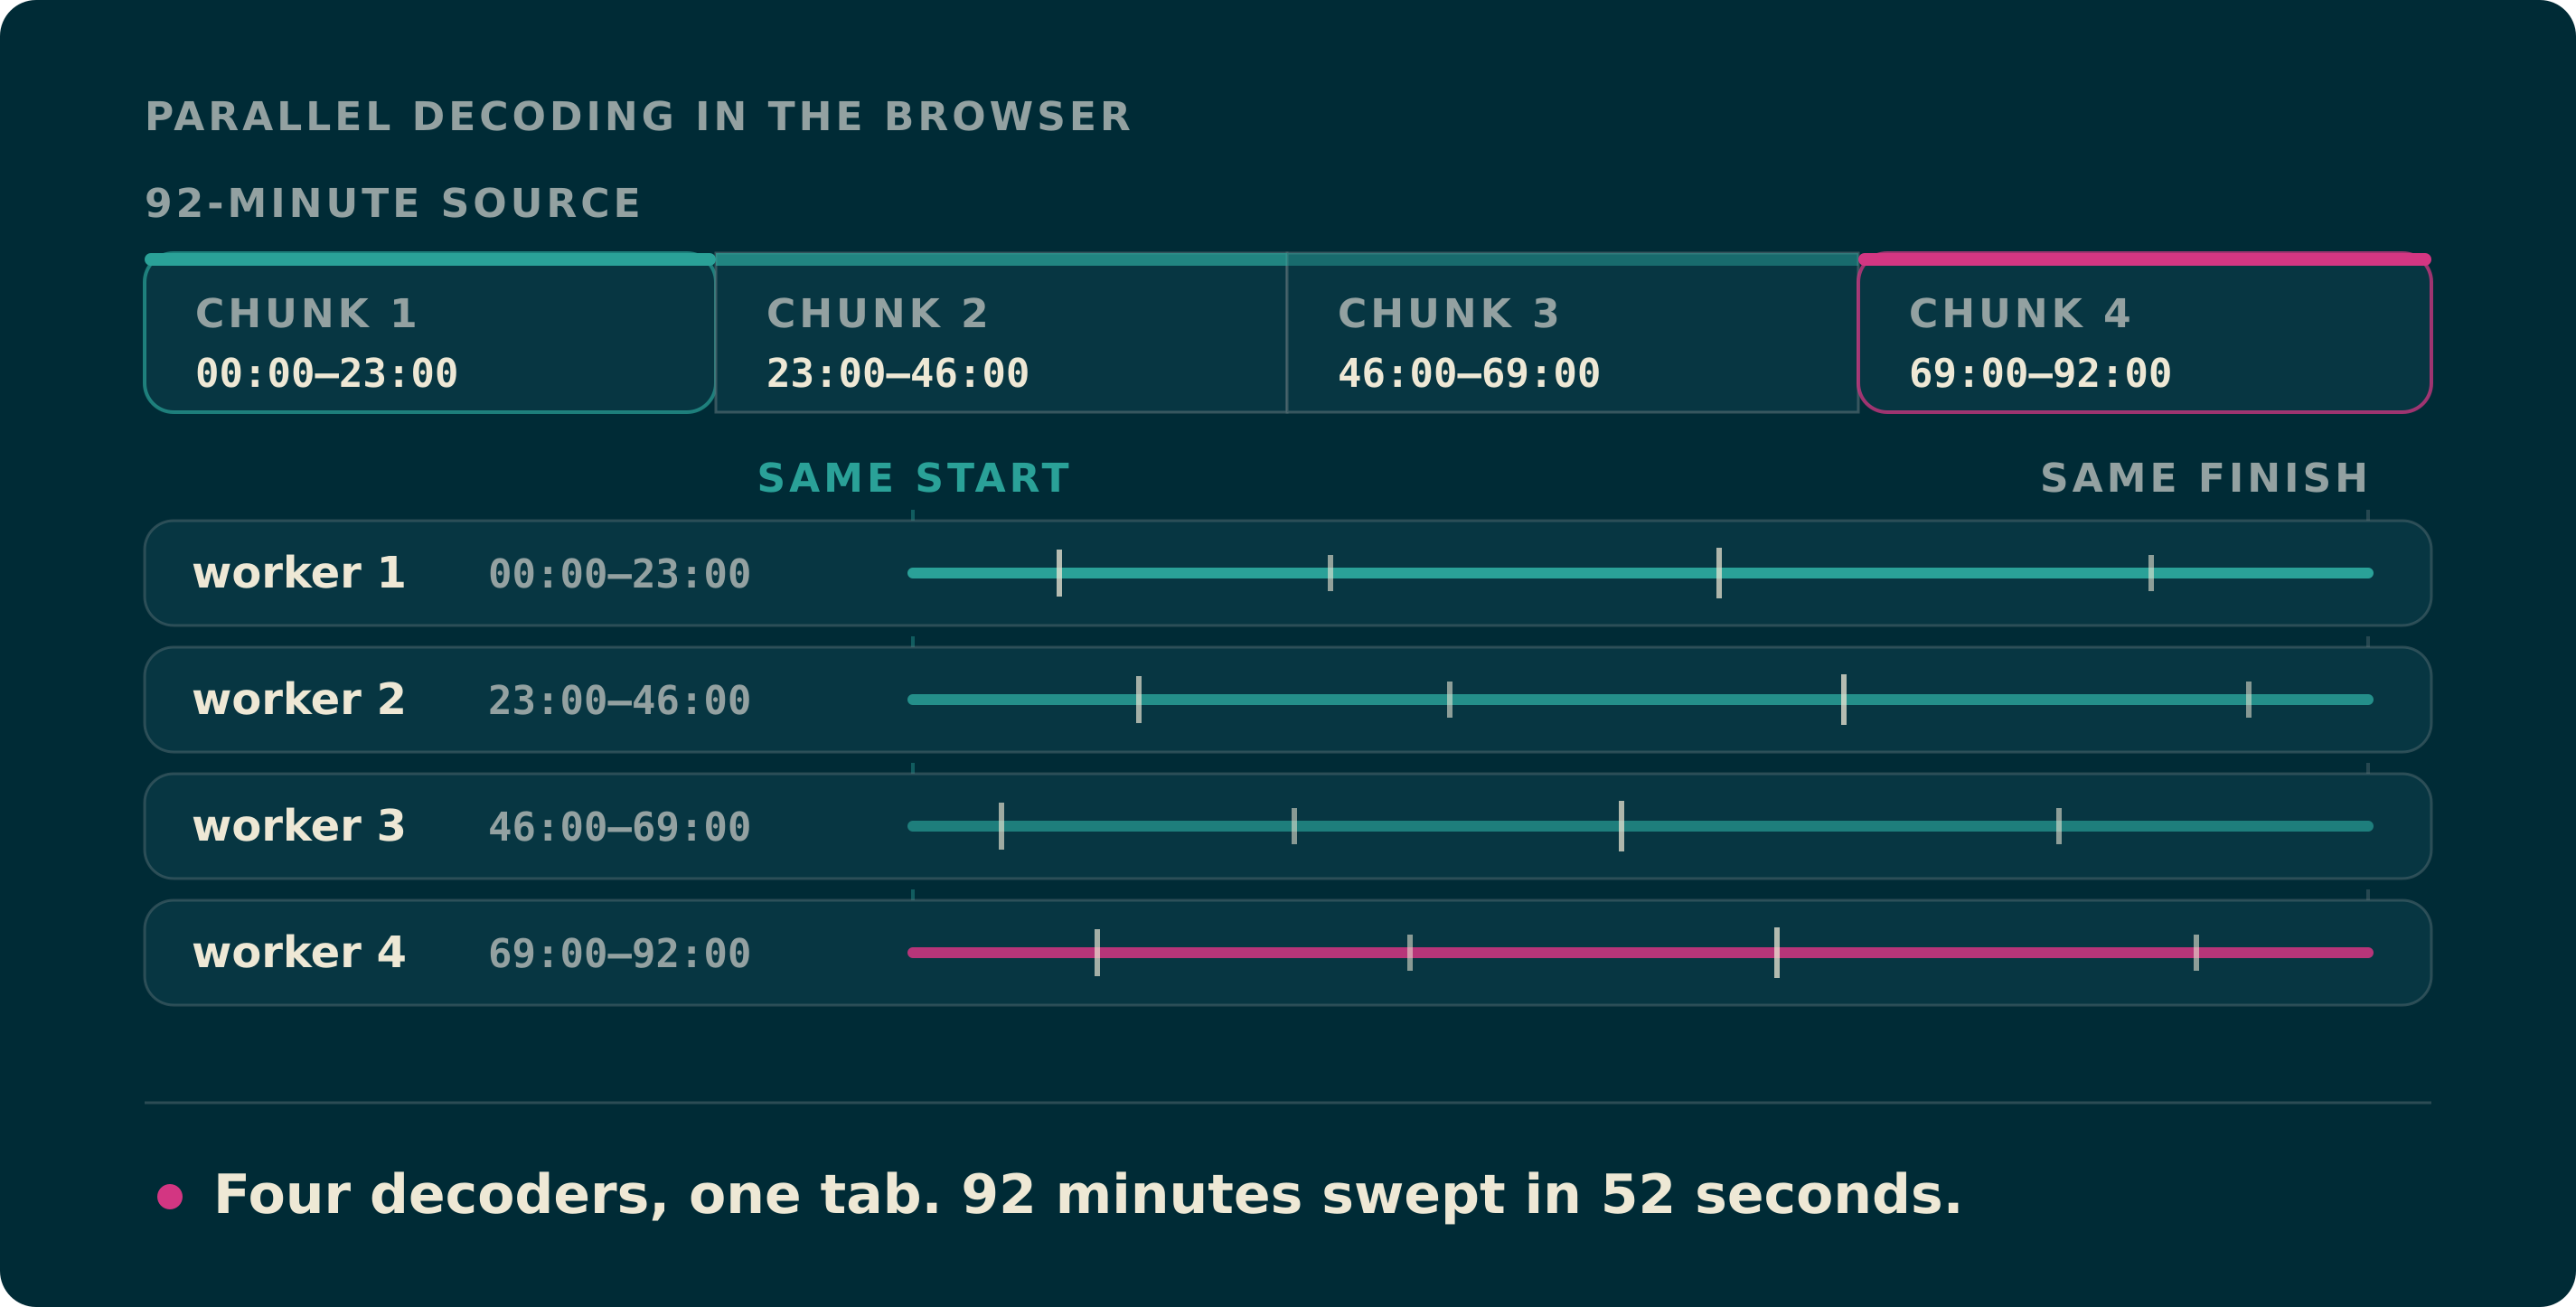
El motor parte el video por tiempo y entrega cada trozo a un worker con su propio VideoDecoder. El pool es min(4, núcleos / 2): usamos la mitad de los núcleos porque la pestaña todavía tiene una interfaz que mover, y ponemos el tope en cuatro por lo que cuenta la sección siguiente.
Cada trozo empieza a barrer un poco antes de su propio rango, para que el detector tenga con qué comparar su primer fotograma, y después descarta lo que cae fuera de lo suyo. Las diapositivas van saliendo según se captura cada una, no todas juntas al final.
Lo que cuesta trocear
Trocear cuesta dos cosas, y ahí está lo interesante. La primera: cada trozo calibra su umbral con su propio fragmento, así que el mismo video partido en cuatro y partido en ocho da presentaciones distintas, es decir que el resultado depende de cuántos núcleos tenga la máquina. La segunda: cada trozo quitaba duplicados solo dentro de sí mismo, así que un plano al que una reunión vuelve una y otra vez sobrevivía una vez por cada trozo en el que aparecía. En una grabación de 29 minutos, tres diapositivas de nueve estaban repetidas.
Los duplicados ya están arreglados: la comprobación pasó al hilo principal y se ejecuta según llega cada diapositiva. La calibración no. Escribimos la versión global y el resultado salió peor: en esa misma reunión, donde ffmpeg cuenta siete cortes reales, calibrar por trozo encuentra seis y calibrar globalmente encuentra cuatro. Por eso el pool se queda en cuatro: trocear más va un 25% más rápido, pero también cambia la respuesta.
No se puede enseñar nada hasta haber leído el video entero
El umbral sale de la distribución de las diferencias entre fotogramas de todo el video, así que el detector no puede elegir la primera diapositiva hasta haber muestreado la última. En una grabación de 92 minutos el barrido tarda 52 segundos y la primera diapositiva aparece en el segundo 50.
Esto no es un problema de rendimiento y no lo arregla ningún grado de paralelismo: es un problema de información. Lo resolvimos escribiendo «Leyendo el video · 45:46 de 92:08» donde antes solo había un porcentaje.
El resto de la pila
La API corre sobre Cloudflare Workers con Hono, las cuentas y los metadatos viven en D1, y las pocas cosas que se guardan van a R2. El front es React 19 con TanStack Router, Tailwind v4 y better-auth. Ocho idiomas, cada uno con su prefijo de URL y su basepath de router.
El sitio es una SPA prerenderizada y no renderizada en servidor: cada página pública es una instantánea HTML estática que generamos al desplegar, y por eso las páginas de marketing se cachean y cargan rápido mientras el conversor funciona sin servidor ninguno. Rompemos esa regla exactamente en un sitio. Las páginas /app son cascarones estáticos, así que el editor arrancaba sin saber nada de tu cuenta y tenía que preguntar; como empezaba a trabajar antes de que llegara la respuesta, un suscriptor de pago acabó con el límite de treinta minutos del plan gratuito. El worker ya tiene la sesión cuando sirve esas páginas, de modo que ahora escribe el plan en el documento y el primer render ya lo conoce. Esas respuestas son privadas y no se cachean nunca; el resto de las páginas conserva su caché pública.
Por qué molestarse
Un servidor haría desaparecer casi todo esto. También significaría que cada clase, cada reunión interna y cada grabación médica que alguien convierte pasaría por nuestras máquinas, y el producto existe justamente para que eso no ocurra.
La restricción no estorba al producto: es el producto. Todo lo anterior es lo que pagamos por ella.