Ocho bugs que parecían ser del algoritmo
Video2Any encuentra las diapositivas de una grabación decodificando fotogramas en el navegador, comparando cada uno con el anterior y quedándose con los que cambiaron lo suficiente. Cuando el resultado sale mal, el sospechoso obvio es esa comparación. Casi nunca es ella.
Estos son ocho problemas que perseguimos en una semana. Solo dos estaban en el detector. Los otros seis fueron una guarda que nadie había limpiado, un script de pruebas que daba números equivocados, una lista virtualizada, una carrera con una llamada a la API, la memoria llegando a su límite y un registro de errores. Ese registro guardaba de cada error justo la parte que no servía para nada.
Los ocho
1. El control que no hacía nada
Nos avisaron de que un video corto daba tres diapositivas en Densa, igual que en Predeterminada. Estuvimos un rato mirando la fórmula del umbral antes de comprobar lo más básico: ¿ese ajuste llegaba al detector?
No llegaba. El primer barrido está protegido por una ref para que corra una sola vez por archivo. Cambiar la densidad reconstruía el callback, pero la guarda devolvía el efecto en el acto, y lo único que volvía a ejecutarse era un botón de un aviso que no tenía nada que ver. Lo que veías tras cambiar el ajuste era el resultado anterior, con las mismas marcas de tiempo. Ahora, en ese mismo clip, Escasa, Predeterminada y Densa dan 3, 6 y 13. Antes las tres daban 6.
2. El script de pruebas se equivocó dos veces
Para explicar un resultado raro reconstruimos la tubería en Node y le dimos el archivo real. Los números no cuadraron con la app, y las dos veces fallaron en direcciones opuestas: primero el script decía 1 diapositiva y la app 6; tras corregirlo, el script decía 15 y la app 6.
Las causas eran dos. El script sacaba los fotogramas con ffmpeg en escala de grises, mientras que el navegador entrega al motor el RGBA de un canvas, y la diferencia entre ambos reescalados basta para mover el umbral calibrado de 0,618 a 0,650. Además el script se saltaba la función que decide si usar la máscara de actividad, así que no recorría el camino que recorre la app. Un script que reproduce el algoritmo pero no la tubería te da una respuesta equivocada con toda la seguridad del mundo.
3. En el DOM solo estaba lo que se veía
Una prueba comprobaba que un video de 32 minutos produjera diapositivas más allá del minuto 30. La prueba leía la marca de tiempo de todas las miniaturas y daba la última en 27:00, que es justo el aspecto que tiene un análisis truncado.
La cuadrícula está virtualizada: solo existen como elementos las filas visibles. Si bajas del todo antes de leer, la última de verdad está en 32:00. Esa aserción llevaba todo el rato midiendo el viewport y no los datos.
4. Cada worker quitaba duplicados por su cuenta
Los videos largos se recorren en trozos paralelos. Cada worker descarta los planos repetidos dentro de su propio trozo —alguien que vuelve a una diapositiva anterior, una llamada que corta al mismo encuadre— y ningún worker ve lo que hicieron los demás.
Así que un plano que reaparecía sobrevivía una vez por cada trozo en el que salía. En una reunión de 29 minutos eran tres diapositivas duplicadas de nueve. Además, el resultado dependía de cuántos trozos hubiera, es decir, de cuántos núcleos tuviera la máquina de quien lo usa. Movimos la comprobación al hilo principal, donde corre según llega cada diapositiva, así que un duplicado no llega a aparecer para luego desaparecer.
5. El diseño más correcto dio el peor resultado
Que cada trozo calibre su propio umbral con su propio fragmento no tiene sentido: un video, una distribución, un umbral. Así que lo escribimos así. Los workers envían las proporciones que midieron, el hilo principal las junta, calibra una vez y devuelve la respuesta.
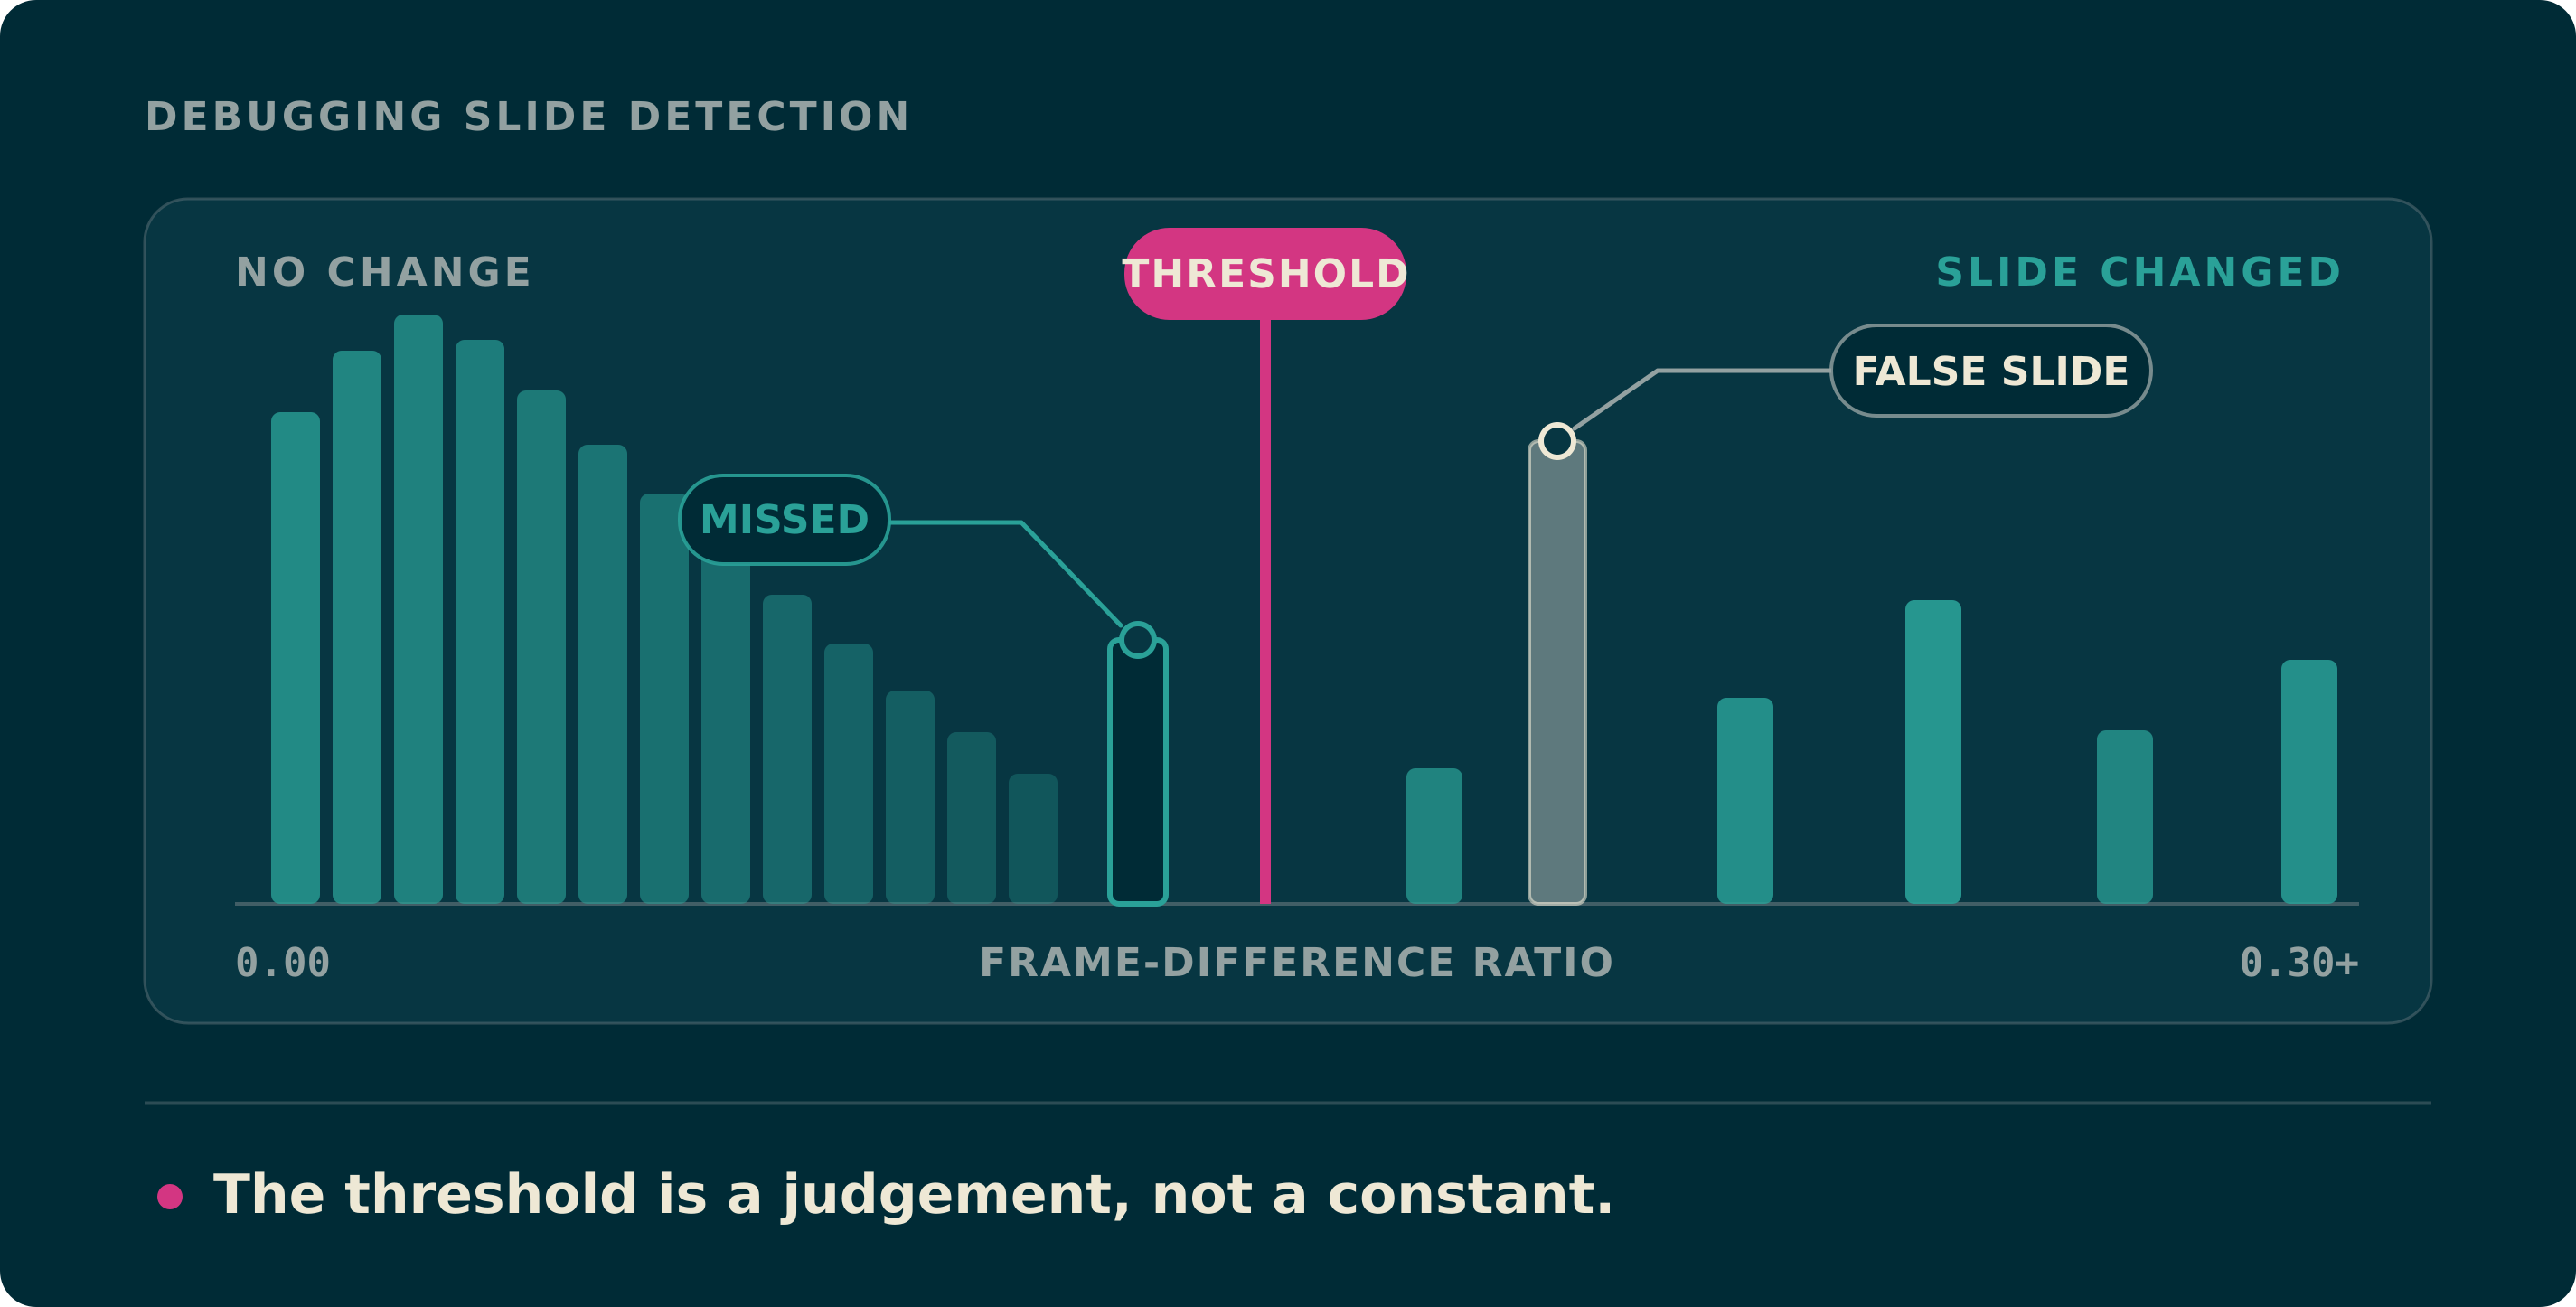
La diferencia entre cuatro trozos y ocho bajó de tres diapositivas a una. Y el resultado empeoró. En esa misma reunión de 29 minutos, donde la detección de escenas de ffmpeg cuenta siete cortes reales, calibrar por trozo más la deduplicación anterior da seis y calibrar globalmente da cuatro. Al juntar las proporciones la distribución se ensancha, sube la mediana más dos MAD y se caen transiciones de verdad. Revertimos el cambio. Un diseño puede ser más correcto y aun así perder contra el que ya tienes, y para verlo necesitas algo fuera de tu propio código con lo que contrastar.
6. Falso porque todavía no habíamos preguntado
Un suscriptor de pago subió una grabación larga y obtuvo solo los primeros treinta minutos. Al pulsar Volver a muestrear salía entera, y eso es lo que lo hacía parecer un problema de detección.
El editor arranca antes de saber quién eres. La marca de suscripción empieza en falso, y ese falso no significa que la respuesta fuera que no, sino que la petición seguía en camino. El límite de duración leyó ese falso y aplicó el techo del plan gratuito. Cuando corría el remuestreo, el plan ya había llegado. Primero lo arreglamos esperando la respuesta; después quitamos la espera: el worker ya tiene la sesión cuando sirve la página, así que escribe el plan en el documento y el primer render ya lo sabe.
7. Todos los errores se llamaban «Error»
La transcripción fallaba más de lo que funcionaba, seis fallos frente a cinco aciertos, y todos quedaban registrados como la cadena «Error». Los diecinueve fallos de extracción, igual.
El código guardaba err.name, que vale «Error» para cualquier error construido a mano. El mensaje, que es donde siempre estuvo la información, no se guardaba en ninguna parte. Al registrarlo entendimos qué pasaba: decodeAudioData remuestrea a la frecuencia del contexto de audio, así que decodificar una clase de 55 minutos a los 48 kHz en estéreo del hardware reserva unos 630 MB de muestras en coma flotante antes de hacer nada más, y dos horas son 1,4 GB. Si decodificas en un contexto que ya está a 16 kHz, el modelo recibe el mismo audio con una sexta parte de la memoria.
8. Era rápido y aun así parecía roto
Una grabación de reunión de 92 minutos se recorre en 52 segundos. La primera diapositiva aparece en el segundo 50.
No había nada lento. El umbral se calibra con la distribución completa de diferencias entre fotogramas, así que no se puede elegir ninguna diapositiva hasta haber leído el video entero, y durante esos 50 segundos lo único en pantalla era un porcentaje. Cuando un número sube solo y no hay nada más al lado, quien mira entiende que el programa se ha quedado colgado. Ahora la pantalla dice qué mitad del trabajo está corriendo y cuánto video lleva leído, y los mismos 52 segundos dejaron de generar quejas.
Lo que le diríamos a quien éramos hace una semana
Comprueba que la entrada llegó al código antes de razonar sobre el código. La mitad de estos casos fueron ajustes que nunca llegaron, respuestas que aún no habían vuelto o una prueba que miraba otra cosa.
Y ten siempre algo fuera de tu tubería con lo que contrastar. La detección de escenas de ffmpeg no es lo que estamos construyendo y no hace falta que lo sea: basta con que sea independiente de nuestro código. Sin ella habríamos publicado la reescritura de la calibración, porque era el mejor diseño, y habríamos perdido sin enterarnos tres diapositivas reales de siete.