Video parallel dekodieren – in einem einzigen Tab
Video2Any hat eine Einschränkung, aus der alles andere folgt: Dein Video verlässt deinen Rechner nicht. Da du keine Datei hochlädst, gibt es auch keinen Server, der die Arbeit übernimmt. Dein Browser dekodiert, vergleicht und rendert also selbst, und zwar in einem Tab, der nebenbei bedienbar bleiben muss.
Im Folgenden steht, was diese Einschränkung tatsächlich kostet und worauf der Rest der Seite aufgebaut ist.
Auf dieser Seite
Den Demuxer schreibst du selbst
WebCodecs gibt dir einen VideoDecoder, der kodierte Chunks in Frames verwandelt. Die Chunks selbst gibt es dazu nicht. Der Browser hat einen MP4-Parser eingebaut — so funktioniert <video> —, aber keine API reicht ihn dir weiter. Also liest du den Container selbst: Du gehst die Boxen durch, findest moov, liest die Sample-Tabelle und gibst dem Decoder einen EncodedVideoChunk nach dem anderen.
Den Container selbst zu lesen bringt einen Vorteil obendrein. Da du ihn ohnehin durchgehst, kannst du jemandem sagen, warum seine Datei nicht aufgehen wird, bevor er fünf Minuten wartet: ProRes ist ein Schnittformat, das kein Browser dekodiert, und verraten wird das vom moov — das bei ProRes oft am Dateiende steht statt am Anfang. Genau deshalb sieht unsere Probe an beiden Enden nach.
Erst abtasten, dann aufnehmen — der Speicher lässt nichts anderes zu
Naheliegend wäre, jeden Frame zu dekodieren und zu vergleichen. Eine 92-Minuten-Aufzeichnung mit 25 fps hat aber 138.000 Frames, und in 1080p hält kein Tab diese Menge.
Die Engine arbeitet deshalb in zwei Durchläufen. Der erste ist der Sweep: Er dekodiert nur die Abtastpunkte und behält jeden in 160×90 — klein genug, dass ein ganzes Video ein paar Dutzend Megabyte Pixel ergibt, groß genug, um eine Folie von der nächsten zu unterscheiden. Erst wenn der Detektor gewählt hat, holt der zweite Durchlauf, das Capture, die Frames in voller Auflösung, und zwar nur die gewählten. Der Sweep nimmt höchstens 900 Samples, und aus dieser Grenze folgt etwas, das man wissen sollte: Ein 29-Minuten-Video und ein 92-Minuten-Video kosten ungefähr gleich viel Zeit, denn die Kosten fallen pro Sample an und nicht pro Minute.
Ein Worker je Abschnitt, jeder mit eigenem Decoder
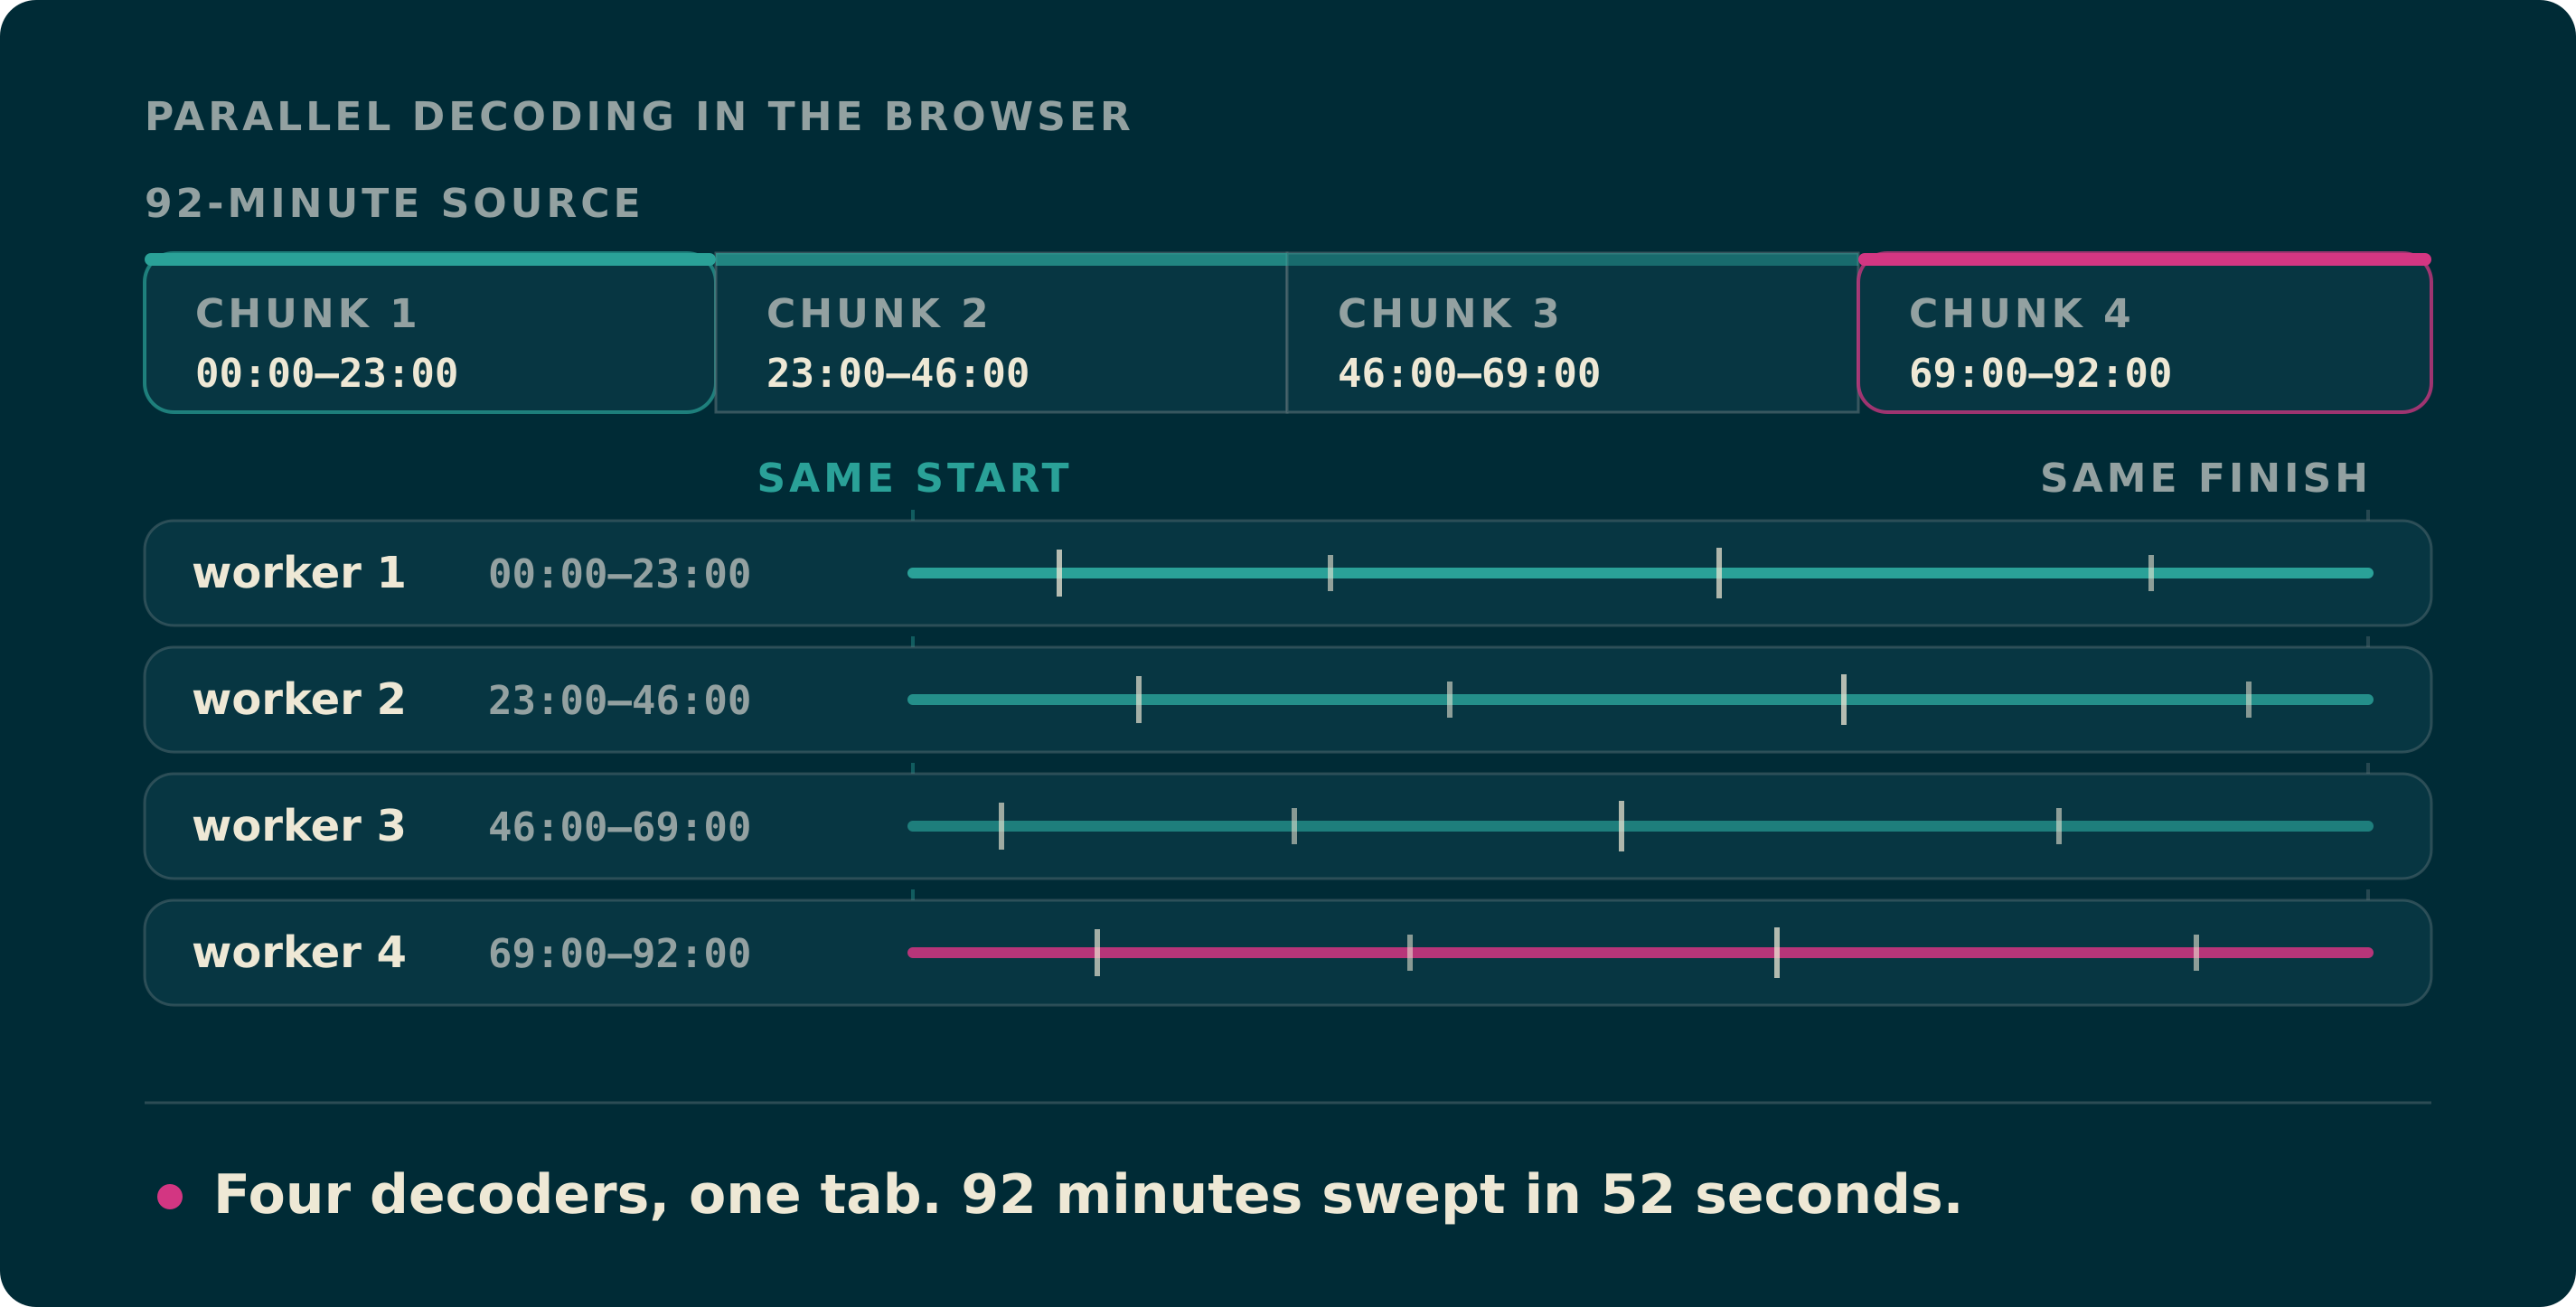
Die Engine teilt das Video zeitlich auf und gibt jeden Abschnitt an einen Worker mit eigenem VideoDecoder. Der Pool ist min(4, Kerne / 2): Wir nutzen die Hälfte der Kerne, weil der Tab noch eine Oberfläche bedienen muss, und wir deckeln bei vier aus dem Grund, den der nächste Abschnitt nennt.
Jeder Abschnitt beginnt etwas vor seinem eigenen Bereich zu tasten, damit der Detektor beim ersten eigenen Frame etwas zum Vergleichen hat, und verwirft danach alles außerhalb. Die Folien kommen heraus, sobald ihre Aufnahme fertig ist, nicht erst am Ende.
Was das Aufteilen kostet
Das Aufteilen kostet zwei Dinge, und da wird es interessant. Erstens kalibriert jeder Abschnitt seinen Schwellenwert auf seinem eigenen Ausschnitt: Dasselbe Video ergibt in vier Teilen einen anderen Foliensatz als in acht, das Ergebnis hängt also davon ab, wie viele Kerne der Rechner hat. Zweitens entfernte jeder Abschnitt Duplikate nur in sich selbst: Eine Einstellung, auf die eine Besprechung immer wieder zurückschneidet, überlebte einmal pro Abschnitt, in dem sie vorkam. Bei einer 29-minütigen Aufzeichnung waren drei von neun Folien doppelt.
Die Duplikate sind erledigt: Die Prüfung liegt jetzt im Haupt-Thread und läuft, sobald eine Folie eintrifft. Die Kalibrierung ist es nicht. Wir haben die globale Variante gebaut, und das Ergebnis wurde schlechter: Bei derselben Besprechung, in der ffmpeg sieben echte Schnitte zählt, findet die Kalibrierung pro Abschnitt sechs und die globale vier. Der Pool bleibt deshalb bei vier: Mehr Abschnitte sind etwa 25 % schneller, ändern aber auch die Antwort.
Vor dem Ende des Videos lässt sich nichts zeigen
Der Schwellenwert kommt aus der Verteilung der Frame-Differenzen über das ganze Video. Der Detektor kann die erste Folie also nicht wählen, bevor der letzte Frame abgetastet ist. Bei einer 92-Minuten-Aufzeichnung dauert der Sweep 52 Sekunden, und die erste Folie erscheint in Sekunde 50.
Das ist kein Performance-Problem, und keine Parallelität der Welt behebt es; es ist ein Problem der Rückmeldung. Wir haben es gelöst, indem wir dort „Video wird gelesen · 45:46 von 92:08“ hinschreiben, wo vorher nur eine Prozentzahl stand.
Der Rest des Stacks
Die API läuft auf Cloudflare Workers mit Hono, Konten und Metadaten liegen in D1, und die wenigen Dinge, die gespeichert werden, gehen nach R2. Das Frontend ist React 19 mit TanStack Router, Tailwind v4 und better-auth. Acht Sprachen, jede mit eigenem URL-Präfix und eigener Router-Basepath.
Die Seite ist eine vorgerenderte SPA und nicht serverseitig gerendert: Jede öffentliche Seite ist ein statischer HTML-Schnappschuss aus dem Deploy, deshalb sind die Marketingseiten cachebar und schnell, und der Konverter kommt ganz ohne Server aus. An genau einer Stelle brechen wir das. Die /app-Seiten sind statische Hüllen, der Editor startete also ohne jedes Wissen über dein Konto und musste erst nachfragen; weil er mit der Arbeit begann, bevor die Antwort da war, bekam ein zahlender Abonnent die Dreißig-Minuten-Grenze der Gratis-Stufe ab. Der Worker hat die Session ohnehin, wenn er diese Seiten ausliefert, also schreibt er den Tarif jetzt ins Dokument, und das erste Rendern weiß Bescheid. Diese Antworten sind privat und werden nie gecacht; alle anderen Seiten behalten ihr öffentliches Caching.
Warum der Aufwand
Ein Server ließe das meiste davon verschwinden. Er hieße aber auch, dass jede Vorlesung, jede interne Besprechung und jede medizinische Aufzeichnung, die jemand umwandelt, über unsere Rechner liefe — und das Produkt gibt es gerade deshalb, damit sie das nicht tun.
Die Einschränkung steht dem Produkt nicht im Weg, sie ist das Produkt. Alles oben ist der Preis, den wir dafür zahlen.