Acht Bugs, die nach dem Algorithmus aussahen
Video2Any findet die Folien in einer Aufzeichnung, indem es im Browser Frames dekodiert, jeden mit dem vorherigen vergleicht und die behält, die sich genug verändert haben. Wenn das Ergebnis nicht stimmt, ist dieser Vergleich der naheliegende Verdächtige. Er ist es fast nie.
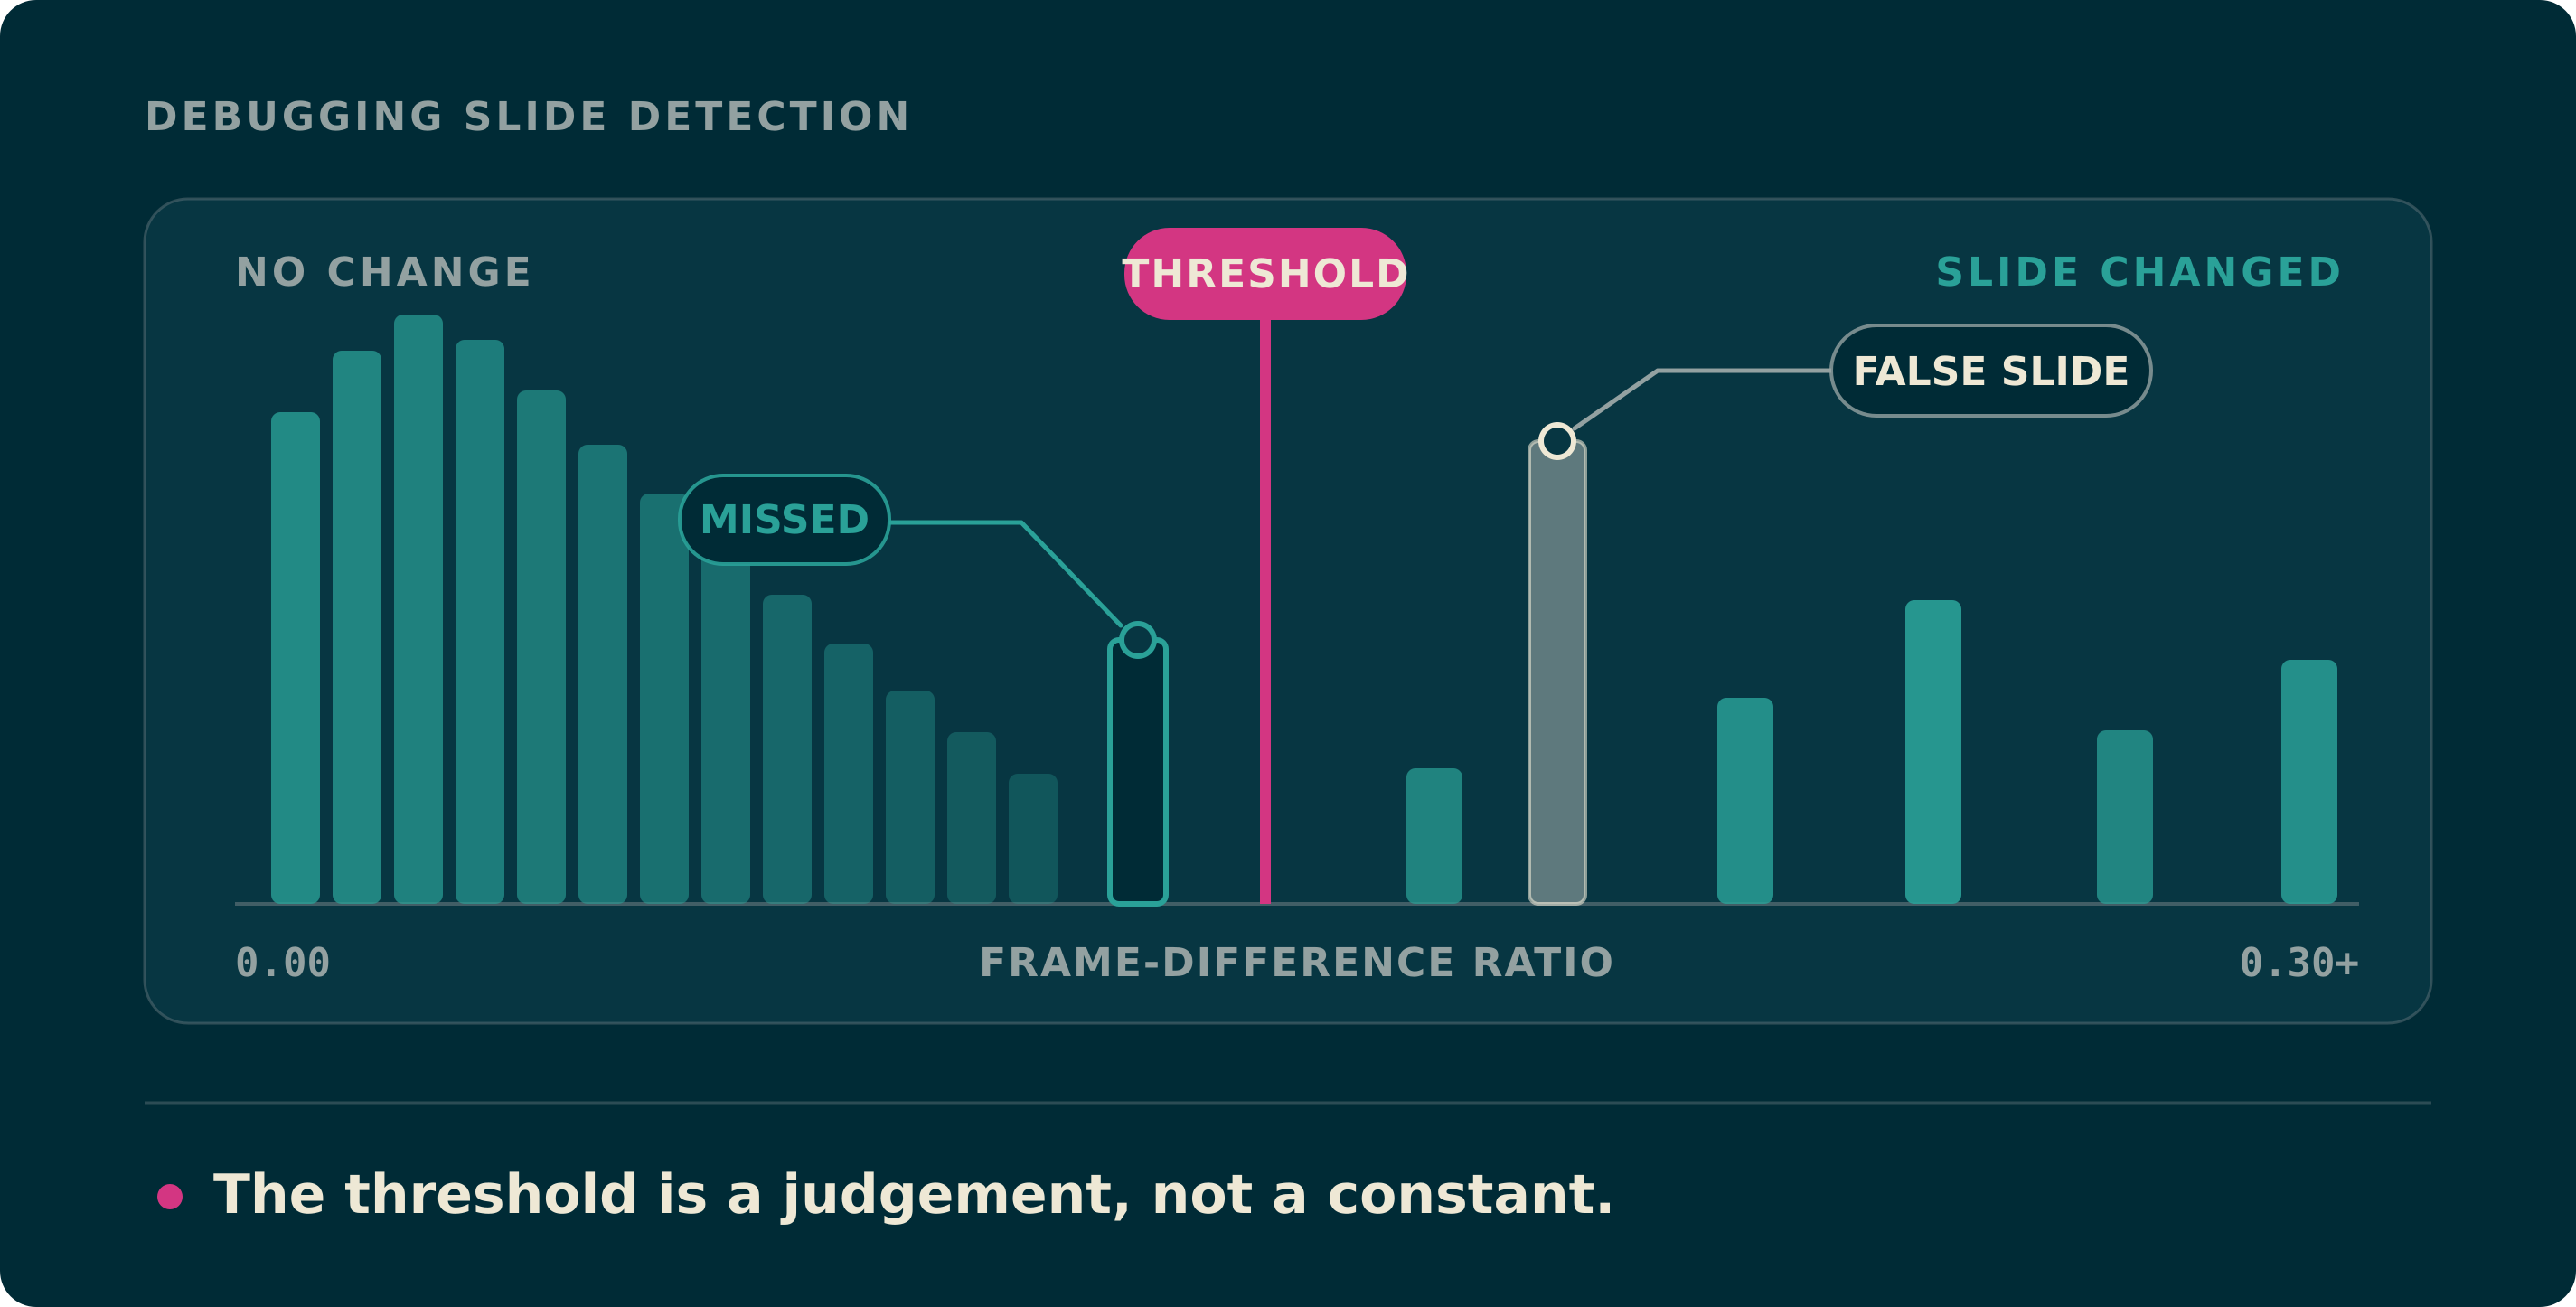
Acht Dinge haben wir in einer Woche gejagt. Zwei davon lagen am Detektor. Die anderen sechs waren ein stehengebliebener Guard, ein Testskript mit falschen Zahlen, eine virtualisierte Liste, ein Wettlauf mit einem API-Aufruf, ein Speicher, der an seine Grenze stieß, und ein Fehler-Log. Dieses Log hat von jedem Fehler ausgerechnet den unbrauchbaren Teil behalten.
Die acht
1. Das Bedienelement, das nichts tat
Gemeldet wurde, dass ein kurzes Video auf Dicht drei Folien liefert, genau wie auf Standard. Wir haben eine Weile auf die Schwellenwert-Formel gestarrt, bevor wir das Naheliegendste geprüft haben: Kam diese Einstellung überhaupt beim Detektor an?
Sie kam nicht an. Der erste Durchlauf ist per Ref abgesichert, damit er pro Datei genau einmal läuft. Die Dichte zu ändern baute den Callback neu, aber der Guard schickte den Effekt sofort wieder zurück, und das Einzige, was tatsächlich neu lief, war ein Button in einem völlig anderen Hinweis. Nach dem Umschalten sahst du das vorherige Ergebnis, mit denselben Zeitstempeln. Auf diesem Clip liefern Sparsam, Standard und Dicht jetzt 3, 6 und 13. Vorher lieferten alle drei 6.
2. Das Testskript hat sich zweimal verrechnet
Um ein merkwürdiges Ergebnis zu erklären, haben wir die Pipeline offline in Node nachgebaut und die echte Datei hineingegeben. Die Zahlen wichen von der App ab, und zwar beide Male in die entgegengesetzte Richtung: erst 1 Folie im Skript gegen 6 in der App, nach der Korrektur 15 gegen 6.
Dafür gab es zwei Ursachen. Das Skript zog die Frames mit ffmpeg in Graustufen, während der Browser der Engine RGBA aus einem Canvas übergibt, und der Unterschied zwischen beiden Skalierungen reicht, um den kalibrierten Schwellenwert von 0,618 auf 0,650 zu verschieben. Außerdem übersprang das Skript die Funktion, die über die Aktivitätsmaske entscheidet, und lief damit gar nicht den Weg, den die App läuft. Ein Skript, das den Algorithmus nachbaut, aber nicht die Pipeline, liefert dir eine falsche Antwort mit voller Überzeugung.
3. Im DOM stand nur, was auf dem Bildschirm war
Ein Test prüfte, ob ein 32-Minuten-Video Folien jenseits der 30-Minuten-Marke erzeugt. Er las den Zeitstempel jedes Thumbnails und meldete den letzten bei 27:00 — genau so sieht eine abgeschnittene Analyse aus.
Das Raster ist virtualisiert: Nur die sichtbaren Zeilen existieren als Elemente. Scrollt man erst ganz nach unten und liest dann, liegt die wirklich letzte Folie bei 32:00. Die Assertion hat die ganze Zeit den Viewport gemessen und nicht die Daten.
4. Jeder Worker entfernte Duplikate für sich
Lange Videos werden in parallelen Abschnitten abgetastet. Jeder Worker verwirft wiederholte Einstellungen innerhalb seines eigenen Abschnitts — jemand kehrt zu einer früheren Folie zurück, eine Konferenz schneidet auf dieselbe Ansicht zurück — und kein Worker sieht, was die anderen tun.
Eine wiederkehrende Einstellung überlebte also einmal pro Abschnitt, in dem sie vorkam. Bei einer 29-minütigen Besprechung waren das drei doppelte Folien von neun. Außerdem hing das Ergebnis davon ab, wie viele Abschnitte es gab, also davon, wie viele Kerne der Rechner am anderen Ende hat. Wir haben die Prüfung in den Haupt-Thread verlegt, wo sie läuft, sobald eine Folie eintrifft: Ein Duplikat erscheint dadurch gar nicht erst, um dann wieder zu verschwinden.
5. Der bessere Entwurf lieferte das schlechtere Ergebnis
Dass jeder Abschnitt seinen eigenen Schwellenwert auf seinem eigenen Ausschnitt kalibriert, ergibt keinen Sinn: ein Video, eine Verteilung, ein Schwellenwert. Also haben wir genau das gebaut. Die Worker schicken die gemessenen Verhältnisse, der Haupt-Thread führt sie zusammen, kalibriert einmal und schickt die Antwort zurück.
Der Abstand zwischen vier und acht Abschnitten schrumpfte von drei Folien auf eine. Und das Ergebnis wurde schlechter. Bei derselben 29-Minuten-Besprechung, in der ffmpeg mit eigener Szenenerkennung sieben echte Schnitte zählt, liefert die Kalibrierung pro Abschnitt plus die obige Duplikatentfernung sechs Folien, die globale Kalibrierung vier. Führt man die Verhältnisse zusammen, verbreitert sich die Verteilung, Median plus zwei MAD steigt, und echte Wechsel fallen heraus. Wir haben die Änderung zurückgenommen. Ein Entwurf kann sauberer sein und trotzdem gegen den verlieren, den du hast. Sehen kannst du das nur, wenn du etwas außerhalb deines eigenen Codes zum Abgleichen hast.
6. Falsch, weil wir noch nicht gefragt hatten
Ein zahlender Abonnent lud eine lange Aufzeichnung hoch und bekam nur die ersten dreißig Minuten. Ein Klick auf Neu abtasten lieferte alles, und genau deshalb sah es nach einem Erkennungsproblem aus.
Der Editor beginnt, bevor er weiß, wer da ist. Das Abo-Flag startet auf falsch, und dieses Falsch heißt nicht, dass die Antwort nein war, sondern dass die Anfrage noch unterwegs war. Die Längenbegrenzung las dieses Falsch und legte die Obergrenze der Gratis-Stufe an. Als das neue Abtasten lief, war der Plan längst da. Zuerst haben wir auf die Antwort gewartet, dann das Warten überflüssig gemacht: Der Worker hat die Session ohnehin, wenn er die Seite ausliefert, also schreibt er den Plan ins Dokument und das erste Rendern weiß Bescheid.
7. Jeder Fehler hieß „Error“
Die Transkription scheiterte häufiger, als sie gelang, sechs zu fünf, und jeder Fehlschlag wurde als die Zeichenkette „Error“ protokolliert. Die neunzehn gescheiterten Extraktionen ebenso.
Der Code speicherte err.name, und der ist bei jedem von Hand erzeugten Error „Error“. Die Message, in der die Information immer schon steckte, landete nirgends. Nachdem wir sie protokolliert hatten, war die Ursache sichtbar: decodeAudioData resampelt auf die Rate des Audio-Kontexts, also entstehen beim Dekodieren einer 55-minütigen Vorlesung mit den 48 kHz Stereo der Hardware zuerst rund 630 MB Float-Samples, bei zwei Stunden 1,4 GB. Dekodierst du auf einem Kontext, der ohnehin bei 16 kHz liegt, bekommt das Modell dasselbe Audio bei etwa einem Sechstel des Speichers.
8. Es war schnell und fühlte sich trotzdem kaputt an
Eine 92-minütige Besprechungsaufzeichnung ist in 52 Sekunden durchgetastet. Die erste Folie erscheint in Sekunde 50.
Nichts daran war langsam. Der Schwellenwert wird aus der gesamten Verteilung der Frame-Differenzen kalibriert, es kann also keine Folie gewählt werden, bevor das Video von vorn bis hinten gelesen ist — und in diesen 50 Sekunden stand nur eine Prozentzahl auf dem Bildschirm. Wenn eine Zahl allein vor sich hin läuft und sonst nichts danebensteht, versteht der Betrachter das als Stillstand. Jetzt steht dort, welche Hälfte der Arbeit läuft und wie viel des Videos gelesen ist, und dieselben 52 Sekunden sind keine Beschwerde mehr.
Was wir uns von vor einer Woche sagen würden
Prüfe, ob die Eingabe überhaupt im Code angekommen ist, bevor du über den Code nachdenkst. Die Hälfte dieser Fälle waren Einstellungen, die nie ankamen, Antworten, die noch nicht zurück waren, oder ein Test, der auf etwas anderes schaute.
Und halte dir etwas außerhalb der eigenen Pipeline zum Abgleichen. Die Szenenerkennung von ffmpeg ist nicht das, was wir bauen, und muss es auch nicht sein: Sie muss nur unabhängig von unserem Code sein. Ohne sie hätten wir die neu geschriebene Kalibrierung veröffentlicht, weil sie der bessere Entwurf war, und dabei unbemerkt drei von sieben echten Folien verloren.